ИТ-специалист видит timeout основного API, а владелец рабочего ИИ-агента ждёт, что операция продолжится через резервную модель. Простое переключение здесь опасно: основная модель могла успеть вызвать инструмент, хотя её итоговый ответ не дошёл. Если fallback повторит вызов, система создаст вторую заявку.
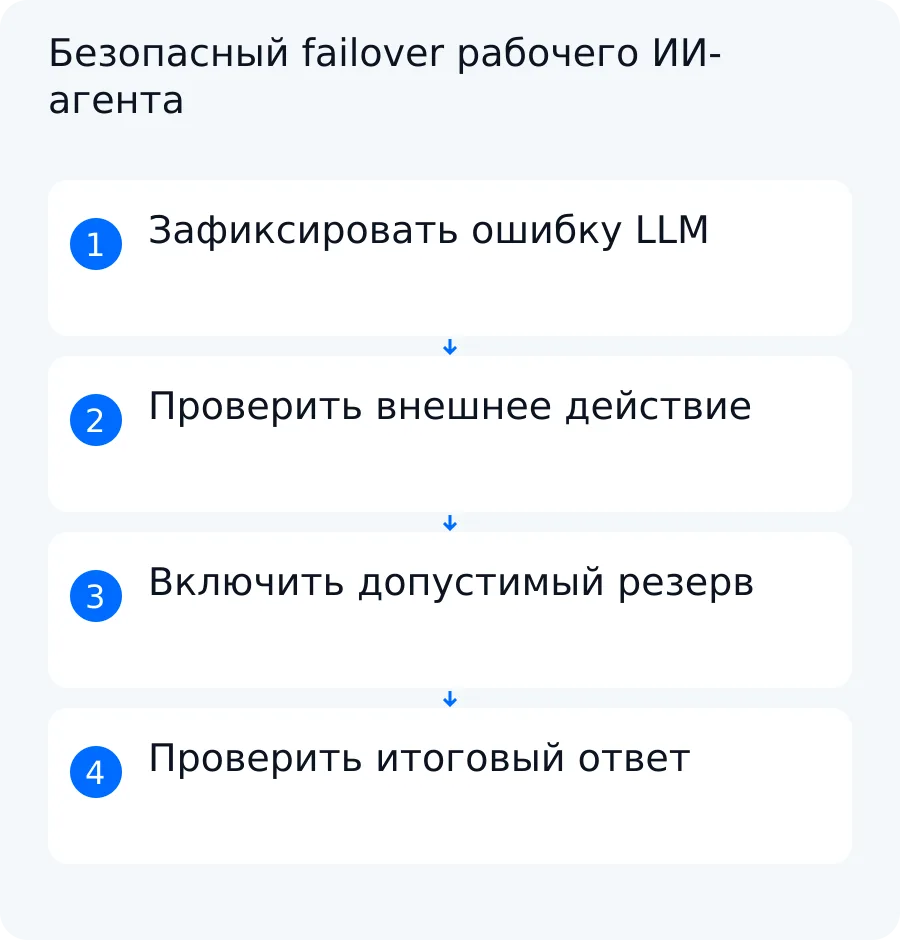
Безопасный failover состоит из двух независимых проверок. Сначала интеграция устанавливает, выполнилось ли внешнее действие. Затем резервная LLM обрабатывает только подтверждённое состояние и формирует ответ в совместимом формате. Так резерв включается по известным условиям и сохраняет проверяемое качество.
Это руководство относится к отказу основного API во время уже выполняемой операции. Оно не помогает выбрать лучшую модель, провайдера или место размещения с нуля.
Какую задачу решает этот процесс
Представим рабочего ИИ-агента, который принимает обращение, вызывает инструмент создания заявки и сообщает результат пользователю. После tool call основной provider не возвращает ответ в установленное время. Команда видит timeout, но ещё не знает, была ли заявка создана.
В этой ситуации нужно получить три результата:
- Классифицировать сбой и решить, разрешён ли failover.
- Проверить фактический итог внешнего действия до любого повтора.
- Получить от резервной модели ответ, соответствующий контракту и подтверждённым данным.
Резервная модель не отменяет бизнес-правила и не исправляет неизвестное состояние инструмента. Она может продолжить обработку только после того, как интеграционный слой установил допустимое следующее действие.
Официальная документация LiteLLM описывает fallback как переход к другой группе моделей после исчерпания настроенных повторов. В ней также указано, что резервные группы перебираются по порядку и для разных классов ошибок могут применяться отдельные правила. Это подтверждает возможность маршрутизации на уровне LiteLLM, но не доказывает совместимость конкретных моделей, structured output, tool calls или правил обработки данных в проекте. Их проверяет команда на собственном контракте.
Для LiteLLM Proxy важно учитывать версию: в документации для версии 1.85.0 и новее тестовые флаги mock_testing_* удаляются из входящих Proxy-запросов и не вызывают fallback. Документация предлагает проверять Proxy через реальную ошибку провайдера в непроизводственной среде. Эта особенность относится к LiteLLM Proxy, а не ко всем маршрутизаторам LLM.
Какие данные и правила подготовить
До настройки failover зафиксируйте не только список моделей, но и контракт всей операции. Иначе переключение сработает технически, а резерв вернёт неподходящий формат или повторит запрещённое действие.
Обязательные данные
- основная и резервная модель с точными идентификаторами конфигурации;
- единая схема ответа: обязательные поля, типы и допустимые значения;
- правила для tool calls и перечень действий, которые можно повторять;
- бюджет времени для основной попытки, проверки состояния, резерва и ответа;
- классы ошибок, при которых разрешены повтор и failover;
- критерии качества и безопасности;
- журнал попыток, переключений и внешних действий;
- идентификатор операции, который связывает вызов модели, tool call и запись во внешней системе.
Условные данные
Они становятся обязательными, только если применимы к процессу: правило ожидания после rate limit, проверка хранения данных у второго провайдера, преобразование схем между моделями, ручное подтверждение критичного действия и отдельный маршрут для отказа по содержанию.
Неизвестные данные
Неизвестное нельзя заполнять предположениями. Если команда ещё не проверила поддержку structured output у резерва, права API или поиск записи по request_id, это блокирует соответствующую ветку failover. Ответственный проводит проверку до запуска либо проектирует безопасную остановку с передачей человеку.
Ниже — заполненный синтетический образец. Model A, Model B, идентификаторы и интервалы условны и не относятся к клиентской системе.
| Поле | Значение синтетического примера | Источник | Ответственный | Статус |
|---|---|---|---|---|
| Основная модель | Model A | Конфигурация интеграции | Разработчик интеграции | Обязательное |
| Резервная модель | Model B | Конфигурация интеграции | Разработчик интеграции | Обязательное |
| Схема ответа | ticket_id, status, message | Контракт API и схема ответа агента | Разработчик интеграции | Обязательное |
| Совместимость функций | Обе модели должны вернуть три обязательных поля; Model B не получает create_ticket | Контракт операции и проверочные сценарии | Разработчик интеграции и владелец процесса | Обязательное; до проверки реальной конфигурации неизвестно |
| Общий бюджет операции | 12 секунд | Политика владельца процесса | Владелец процесса | Обязательное |
| Основная попытка | До 5 секунд | Настройка интеграции | Разработчик интеграции | Обязательное |
| Проверка действия | До 2 секунд | Контракт API инструмента | Разработчик интеграции | Обязательное |
| Резервный ответ | До 4 секунд | Настройка интеграции | Разработчик интеграции | Обязательное |
| Временной запас | 1 секунда | Политика владельца процесса | Владелец процесса | Обязательное |
| Ошибки переключения | Timeout, временная недоступность | Классификатор ошибок интеграции | Разработчик и ИТ | Обязательное |
| Идентификатор операции | REQ-1042 | Журнал вызовов | Разработчик интеграции | Обязательное |
| Журнал переключений | Время попытки, модель, класс ошибки, request_id, результат проверки действия и выбранная ветка | Требования к эксплуатации | ИТ и разработчик интеграции | Обязательное |
| Критерий качества | Три поля заполнены; ticket_id совпадает с найденной записью | Правило приёмки | Владелец процесса | Обязательное |
| Ожидание после rate limit | По ответу API или локальной политике | Документация выбранного API | ИТ | Условное |
| Допустимость передачи данных резерву | Пока не подтверждена для реального проекта | Требования к данным и договоры | ИТ/ИБ | Неизвестное до проверки |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Условный бюджет считается целиком: 5 + 2 + 4 + 1 = 12 секунд. Это не дополнительные 12 секунд после сбоя и не универсальная настройка. Если проверка по request_id не уложилась в отведённые 2 секунды или вернула неопределённый результат, резерв не получает команду повторно создать заявку. Система сообщает о необходимости ручной сверки.
Когда нужен резервный провайдер
Не каждая ошибка основной модели означает, что запрос нужно отправить другой LLM. Сначала классифицируйте причину.
| Ситуация | Что означает | Допустимое действие |
|---|---|---|
| Timeout или временная ошибка | Ответ не получен либо provider временно недоступен | Проверить состояние внешней операции; затем выполнить ограниченный повтор или включить резерв |
| Rate limit | Провайдер ограничил частоту запросов | Учесть указание API об ожидании, если оно доступно, либо локальную политику; затем выбрать ограниченный повтор или резерв |
| Отказ по содержанию | Запрос остановлен политикой обработки содержания | Не использовать другой provider для обхода отказа; вернуть контролируемый ответ или передать случай ответственному |
| Дефект входных данных | Не хватает обязательного поля, неверен тип или нарушен контракт | Исправить данные либо запросить уточнение; не рассылать тот же ошибочный запрос всем моделям |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Автоматическое правило «при любой ошибке вызвать Model B» смешивает технический сбой и содержательную проблему. Оно расходует запросы, затрудняет расследование и может обходить установленное ограничение.
Для временной ошибки отдельно определите, на каком этапе она возникла. Если модель ещё не вызывала инструмент, повтор обычно затрагивает только генерацию. Если tool call уже начался, сначала нужен запрос состояния внешней операции. Статус HTTP или исключение клиента сами по себе не доказывают, что удалённая система ничего не изменила.
Как переключать модель без двойного действия
Безопасное переключение начинается до первого вызова инструмента. Интеграция присваивает операции request_id и записывает его в журнал. Затем тот же идентификатор передаётся внешнему инструменту, если его API поддерживает идемпотентный ключ или поиск результата по такому ключу.
Один request_id не гарантирует защиту. Внешняя система или промежуточный слой должны уметь сделать хотя бы одно из двух:
- идемпотентно обработать повтор с тем же ключом;
- найти ранее созданную запись по request_id и вернуть её состояние.
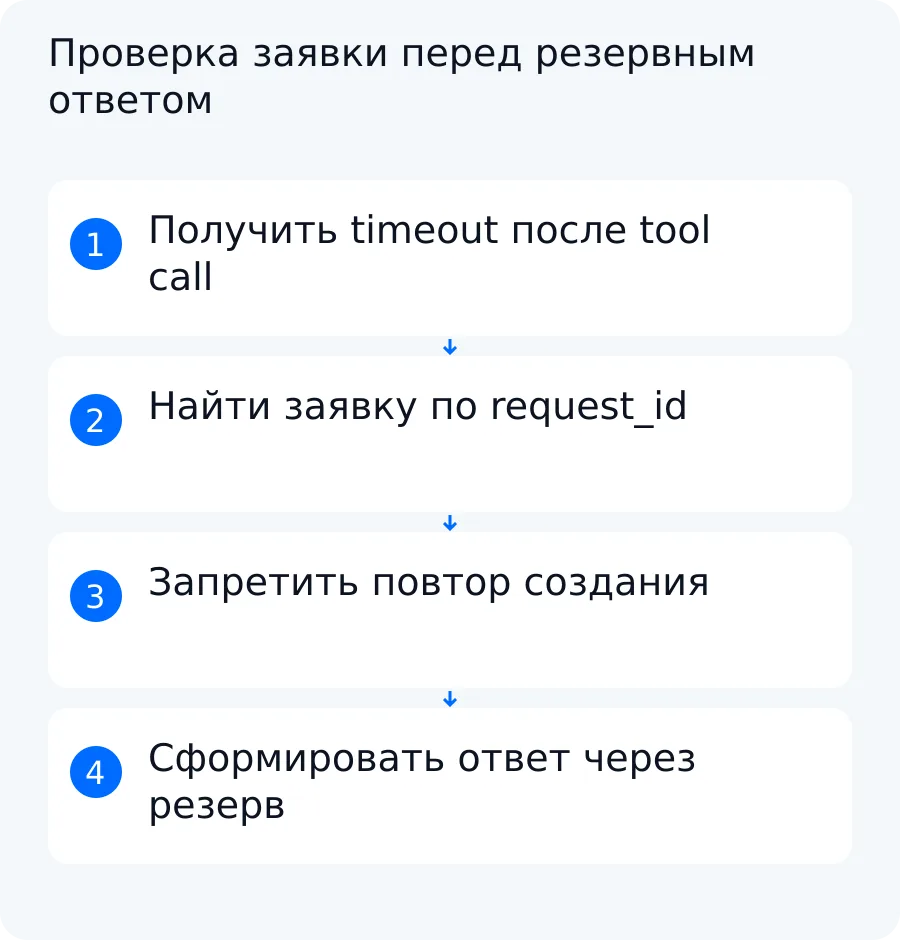
После неопределённого результата порядок такой:
- Записать ошибку основной модели и состояние попытки.
- Запросить результат внешней операции по request_id.
- Если запись найдена, запретить повторное создание и сохранить её идентификатор и статус.
- Если подтверждено, что действие не выполнялось, применить заранее согласованное правило повтора.
- Если состояние осталось неизвестным, остановить автоматическую ветку и передать проверку человеку.
- Передать резервной модели только подтверждённые данные и разрешённое действие.
- Проверить structured output перед формированием ответа пользователю.
Model A и Model B должны проходить один контрактный набор проверок. Сравните обязательные поля, типы, допустимые значения, поддержку нужного режима structured output, ограничения tool calls и обработку ошибок. Если Model B не может безопасно вернуть требуемую схему или соблюдать запрет на инструмент, failover для этой операции запрещён.
Разделяйте решение модели и выполнение действия. Резерв может подготовить сообщение по уже созданной заявке, не получая инструмент create_ticket. Это уменьшает область возможной ошибки: Model B видит ticket_id и status, но технически не может создать дубль.
Как вернуться к основной модели
Если каждый новый запрос немедленно проверяет отказавший provider, система создаёт лишнюю нагрузку и увеличивает задержку. Для временного исключения основной модели применяют circuit breaker: после заданного числа ошибок маршрут открывается, запросы временно идут по безопасной резервной ветке, а затем выполняется ограниченная проба.
Синтетическое правило может выглядеть так:
- После трёх последовательных временных ошибок открыть circuit breaker на 60 секунд.
- После паузы отправить один пробный запрос без внешнего изменения данных.
- Проверить ответ по контрактной схеме и контрольному набору.
- Закрыть circuit breaker только после успешной пробы.
- При новой ошибке снова открыть его и уведомить ответственного по согласованному правилу.
Три ошибки и 60 секунд — условные настройки примера, а не рекомендация для любого API. Реальные значения выбирают по допустимой задержке, ограничениям provider и характеру операции.
Технический ответ основной модели ещё не означает полноценное восстановление. Контрольный набор должен выявлять:
- пропуски обязательных полей;
- изменение типов или допустимых значений;
- ошибочный выбор tool call;
- попытку повторить подтверждённое внешнее действие;
- ухудшение ответа на типовых и граничных запросах;
- различия в правилах передачи, хранения и обработки данных.
Для синтетического набора из 10 задач можно задать два независимых порога: не менее 9 корректных структурированных ответов и 10 из 10 запретов на повтор действия после подтверждённой заявки. Если корректны 9 ответов, quality_rate = 9 / 10 × 100% = 90%. Если дублей нет, duplicate_rate = 0 / 10 × 100% = 0%. Эти показатели нельзя взаимозачесть: 90% качества текста не компенсируют даже одно запрещённое действие.
Учебный пример: путь от входных данных до результата
Ниже приведён синтетический учебный пример, а не клиентский кейс, файл Switch On AI или результат живого теста. Все модели, идентификаторы и интервалы условны.
Исходные данные
- Model A обрабатывает обращение и вызывает
create_ticket. - До tool call интеграция присвоила операции
request_id=REQ-1042. - Схема ожидаемого ответа содержит
ticket_id,statusиmessage. - На основную попытку отведено 5 секунд, на проверку действия — 2 секунды, на резервный ответ — 4 секунды, запас составляет 1 секунду.
- Полный условный бюджет операции равен 12 секундам.
Model A получает timeout после вызова создания заявки. Журнал подтверждает отправку tool call с REQ-1042, но не содержит достоверного результата. Поэтому повтор пока запрещён.
Промежуточное решение
Интеграция ищет результат по REQ-1042. Проверка находит заявку T-731 со статусом created. Система записывает action_confirmed=true и допустим_повтор=false.
Model B получает только подтверждённые значения ticket_id=T-731 и status=created, а также задачу сформировать пользовательское сообщение. Команда create_ticket резервной модели недоступна. После генерации интеграция проверяет наличие трёх обязательных полей и совпадение ticket_id с найденной записью.
| Ошибка | Допустим повтор | Модель | Проверка действия | Ответ пользователю |
|---|---|---|---|---|
Timeout после create_ticket | Нет, пока не проверен request_id; после обнаружения записи повтор запрещён | Model B только для ответа | По REQ-1042 найдена заявка T-731, status=created | «Заявка T-731 создана; повторное создание не выполнялось» |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Результат примера — одна подтверждённая заявка и ответ по её фактическому состоянию. Failover продолжил коммуникацию, но не повторил внешнее действие.
Если бы проверка не нашла запись, это ещё не доказывало бы отсутствие заявки: поиск мог быть недоступен или результат мог появиться с задержкой. При неопределённом состоянии автоматическая ветка остановилась бы и попросила сотрудника сверить операцию. Честное сообщение о задержке безопаснее ложного успеха или дубля.
Как проверить результат перед запуском
Failover нужно проверять как отдельный рабочий процесс, а не как единственный успешный запрос к резервной модели. Для каждого сценария заранее запишите вход, ожидаемый результат, сигнал ошибки и действие человека.
| Сценарий | Ожидаемый результат | Сигнал ошибки | Действие человека |
|---|---|---|---|
| Model A отвечает в срок | Ответ соответствует схеме; внешний инструмент вызван не более разрешённого числа раз | Нет обязательного поля, неверный тип или лишний tool call | Остановить выпуск этой конфигурации и разобрать журнал |
| Model A недоступна до tool call | После ограниченных попыток запрос уходит Model B; ответ проходит схему | Резерв не отвечает или возвращает несовместимый формат | Перевести операцию в ручной режим |
| Timeout после tool call, запись найдена | Повтор запрещён; Model B сообщает подтверждённый результат | Создана вторая запись либо ответ содержит другой ticket_id | Остановить автоматическую ветку, сохранить журнал, устранить причину дубля |
| Timeout после tool call, состояние неизвестно | Повтор создания не выполняется; пользователь получает сообщение о проверке | Система сообщает об успехе без подтверждения | Сверить внешнюю систему вручную |
| Rate limit | Выполняется согласованное ожидание, ограниченный повтор или переход на резерв | Бесконечные повторы либо игнорирование лимита | Проверить политику повторов и нагрузку |
| Отказ по содержанию | Контролируемый отказ не обходится через другую модель | Запрос автоматически отправлен резерву ради обхода | Отключить такую ветку и уточнить правила обработки |
| Некорректный вход | Система запрашивает данные или завершает обработку с понятной ошибкой | Тот же неверный запрос отправляется всем моделям | Исправить валидацию входа |
| Возврат к Model A | Пробный запрос без внешнего действия и контрольный набор проходят критерии | Ошибка формата, качества или политики данных | Оставить circuit breaker открытым и разобрать различия |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Отдельно проверьте три ограничения.
Совместимость. Failover не скрывает различия API. Одинаковое название поля не гарантирует одинаковый тип, а поддержка tool calls одной моделью не подтверждает безопасную работу другой.
Отсутствие дублей. Сравните журнал вызовов с записями внешней системы. Успешный текстовый ответ не доказывает, что операция выполнена ровно один раз.
Цена и качество. Не считайте резерв равным основной модели автоматически. Расход, задержку и качество измеряют на одном наборе задач и при сопоставимых условиях. До такой проверки в требованиях фиксируют их как отдельные характеристики.
После изменения модели, схемы, инструмента, правил повторов или политики данных повторите затронутые сценарии. Проверка одной ветки не подтверждает остальные.
Что согласовать для внедрения
Готовый маршрутизатор может выполнять повторы, cooldown и переход между группами моделей. Например, документация LiteLLM описывает последовательные fallbacks после настроенных повторов. Но готовый инструмент не знает бизнес-смысла операции: можно ли повторно создать заявку, где проверить результат и кто принимает неопределённое состояние.
Собственная интеграция связывает маршрутизацию с рабочим процессом. В ней задают request_id, журнал, проверку внешнего действия, контракт structured output, доступные tool calls, ручную ветку и критерии возврата. Конкретные возможности выбранной модели, provider, тарифа, прав API и режима обработки данных проверяются отдельно. Эта статья не доказывает совместимость конкретной конфигурации или опыт внедрения упомянутого вендора.
Switch On AI разрабатывает ИИ-помощников и ИИ-агентов под конкретные операции, а также ботов или обычные интеграции, если агентный выбор действий не нужен. Для сценария failover работа начинается с проверки данных и доступных API. Затем можно описать одну операцию: условия резерва, критичные действия, запреты на повтор и способ приёмки. Правила бухгалтерского, юридического, кадрового и отраслевого учёта задаёт и проверяет специалист заказчика.
Задача проекта — добиться состояния, при котором резерв включается по известным условиям и сохраняет проверяемое качество. Прототип может показать ключевую ветку на согласованных примерах, но не считается полноценным внедрением и не подтверждает работу со всеми провайдерами или системами.
Следующий шаг — обсудить критичные действия агента и допустимый резерв. Подготовьте одну операцию, пример обычного запроса, пример сбоя и перечень действий, которые нельзя повторять без проверки. Затем можно разобрать операцию и согласовать границы прототипа без обещания срока, эффекта или совместимости до проверки.
Вопросы по этой задаче
Любая ли модель подходит как резерв?
Нет. Резерв должен поддерживать обязательную схему ответа, допустимые типы, нужный режим structured output и безопасные ограничения tool calls. Отдельно проверяют качество, расходы и правила обработки данных. Если совместимость не подтверждена, failover для критичной операции не включают.
Можно ли повторять вызовы инструментов?
Только по заранее заданному правилу. После timeout сначала проверяют факт выполнения по request_id или другому поддерживаемому механизму идемпотентности. Если действие уже выполнено либо его состояние неизвестно, повтор запрещают.
Когда возвращаться к основному провайдеру?
После ограниченной паузы выполняют пробный запрос без внешнего изменения данных, а затем проверяют контрактный набор задач. Основной маршрут возвращают только после успешной пробы и прохождения критериев качества и безопасности.