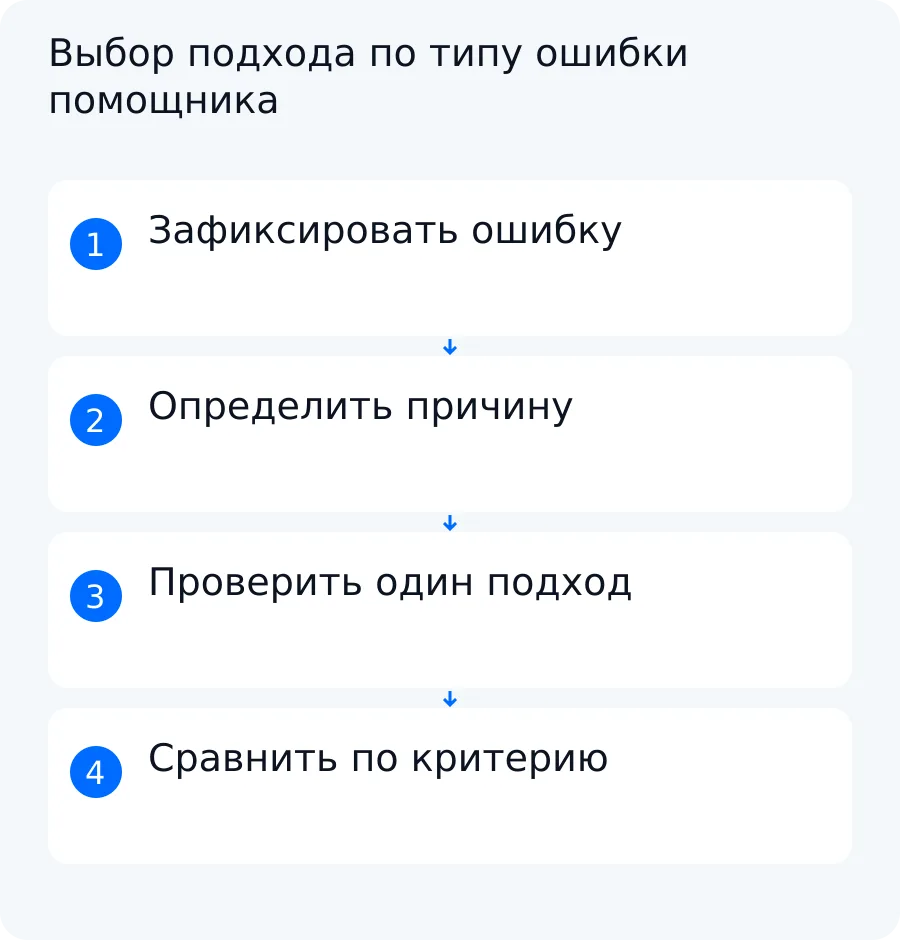
Если корпоративный помощник ошибается, не начинайте с выбора технологии. Сначала определите тип дефекта. Неверный ответ по новому регламенту указывает на проблему с доступом к знаниям, актуальностью корпуса или поиском. Карточка с пропущенными полями указывает на проблему инструкции, примеров или устойчивого поведения модели.
RAG, fine-tuning и улучшение инструкции решают разные задачи. Их можно сочетать, но гибрид не нужен по умолчанию. Решение принимают после сравнения вариантов на одном зафиксированном наборе заданий.
Какие проблемы решают RAG и fine-tuning
RAG — это схема, при которой система находит фрагменты во внешнем корпусе и передаёт их модели как контекст для ответа. Документы при этом не превращаются в веса модели. Если завтра владелец заменит регламент, система должна обновить доступный корпус или индекс и находить новую редакцию.
Например, сотрудник спрашивает: «Кто согласует исключение по новому регламенту?» Помощник ищет разрешённый документ, получает нужный фрагмент и формирует ответ с указанием источника. Здесь задача состоит в доступе к актуальному знанию во время запроса.
Fine-tuning — дообучение предварительно обученной модели на специальной обучающей выборке с изменением её весов. Такой подход рассматривают, когда нужно закрепить повторяемое поведение: стиль ответа, порядок полей, формат или способ выполнения однотипной задачи.
Например, помощник каждый раз должен выдавать карточку с полями «Тема», «Основание», «Ответственный» и «Следующий шаг». Если ясная инструкция и хорошие примеры не обеспечивают устойчивый формат, можно проверить fine-tuning на качественной выборке правильных карточек.
Дообучение не следует считать способом хранения действующей редакции регламента. Оно также не гарантирует улучшения само по себе: результат зависит от данных и проверяется на отдельной оценочной выборке.
Поэтому выбор нельзя сводить к формуле «RAG дешевле, fine-tuning дороже». У подходов разные данные, цепочки обновления, ограничения и эксплуатационные расходы. Первый вопрос звучит так: что именно сломано — получение факта или поведение модели?
Когда начать с поиска по документам
Начните с RAG, если правильный ответ должен опираться на изменяемые корпоративные документы и сотруднику важно проверить основание. Типовая учебная последовательность выглядит так:
- Помощник получает вопрос пользователя.
- Система отбирает документы, доступные этому пользователю.
- Поиск находит релевантные фрагменты.
- Модель получает вопрос и найденный контекст.
- Помощник отвечает и указывает документ-основание.
В этой цепочке отдельной проверки требует каждый переход. Наличие слова RAG в архитектуре ничего не исправляет, если индекс содержит старую редакцию, поиск возвращает соседний раздел или фильтр прав открывает чужие документы.
Проверьте три условия.
Актуальность. У каждого документа должны быть владелец, версия или дата действия и понятный порядок обновления корпуса. Если две редакции противоречат друг другу, система не должна молча выбирать удобную.
Релевантность поиска. Для контрольного вопроса сохраните ожидаемый документ и фрагмент. Затем проверьте, попал ли он в результаты поиска до формирования ответа. Так можно отделить дефект поиска от ошибки модели при работе с уже найденным текстом.
Права доступа. Поиск должен учитывать полномочия пользователя до передачи фрагментов модели. Запрет нельзя реализовать одной фразой в инструкции: недоступный документ не должен попадать в контекст.
Если задача шире и нужно подготовить сами документы, порядок их отбора и обновления разобран в руководстве о базе знаний для ИИ. Здесь достаточно зафиксировать главное: RAG отвечает за получение подходящего внешнего контекста, но качество корпуса и поиска остаётся отдельной инженерной задачей.
Когда рассматривать дообучение
Fine-tuning имеет смысл рассматривать, когда ошибка повторяется в устойчивой задаче, а команда располагает качественными примерами входа и ожидаемого выхода. Возможные цели — единый стиль, соблюдение схемы ответа, повторяемый порядок действий или обработка известных типов запросов.
До обучения проверьте более простую гипотезу: достаточно ли уточнить инструкцию и добавить несколько показательных примеров. Если это устраняет дефект на оценочном наборе, дополнительный этап может не понадобиться.
Если ошибка сохраняется, разделите данные:
- обучающая выборка содержит правильные пары «задание — ответ» и охватывает существенные варианты;
- оценочная выборка не участвует в подготовке и нужна для честного сравнения;
- сложные и запрещённые случаи входят в проверку, даже если их неудобно размечать;
- критерий успеха задан до эксперимента.
Сравните базовую и дообученную модели на одной оценочной выборке. Проверяйте не общее впечатление, а нужное поведение: обязательные поля, допустимые значения, отсутствие лишних полей и корректную реакцию при нехватке данных.
Плохие или однородные примеры могут закрепить ошибку. Изменение базовой модели или состава данных может потребовать нового эксперимента и повторной оценки. Поэтому fine-tuning — не разовая кнопка улучшения, а отдельный цикл подготовки данных, обучения и контроля.
Как сравнить данные, эксплуатацию и ограничения
Сравнивайте не только запуск, но и весь жизненный цикл: подготовку данных, эксперимент, обновление, проверку и поддержку. Конкретные суммы зависят от выбранной платформы, модели, объёма данных и нагрузки; без собственного замера их нельзя подставить в решение.
| Подход | Какие данные нужны | Что обновлять | Что проверять | Эксплуатационные затраты | Основное ограничение |
|---|---|---|---|---|---|
| Улучшение инструкции | Правила задачи и несколько эталонных примеров | Текст инструкции и примеры при изменении процесса | Формат, смысл, исключения и регрессии на фиксированном наборе | Подготовка и сопровождение инструкции, повторные проверки | Длинная или противоречивая инструкция не обеспечивает устойчивость сама по себе |
| RAG | Разрешённый корпус, метаданные, версии и правила доступа | Документы, индекс и фильтры доступа | Актуальность, релевантность поиска, источник ответа и отсутствие утечки | Подготовка корпуса, индексация, запросы, наблюдение и поддержка обновлений | Плохой поиск или устаревший корпус передаёт модели неверный контекст |
| Fine-tuning | Качественная и представительная обучающая выборка | Данные и, при необходимости, дообученную модель | Сравнение с базовой моделью на отдельной оценочной выборке | Разметка, обучение, эксперименты, размещение и повторная оценка | Не гарантирует актуальные факты и может закрепить дефекты данных |
| Гибрид | Корпус для знаний и примеры для поведения | Обе цепочки: документы, поиск, данные и модель | Поиск и поведение раздельно, затем полный сценарий | Подготовка и поддержка обеих цепочек | Сложнее определить причину ошибки и дороже сопровождать изменения |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Для сметы выделите как минимум четыре группы работ: подготовка данных, эксперимент, обновление и поддержка. Для RAG отдельно оцените очистку документов, индексацию и контроль прав. Для fine-tuning — разметку, обучение нескольких вариантов и независимую оценку. Для гибрида нельзя считать только стоимость вызова модели: обе цепочки требуют владельцев и повторных проверок.
Когда помогают инструкция и гибридный подход
Начинайте с самой простой гипотезы, которую можно проверить на реальном дефекте. Если помощник забывает обязательное поле, уточните инструкцию, покажите правильный и ошибочный примеры, затем повторите проверку на прежнем наборе. Если он не знает новое правило, сначала убедитесь, что актуальный документ доступен и находится по контрольному вопросу.
Гибрид нужен, когда подтверждены две разные задачи. RAG доставляет актуальные фрагменты, а инструкция или дообученная модель определяет, как использовать их и в каком формате выдать результат. Ответственность лучше разделить:
- поисковая часть отвечает за доступ, актуальность и релевантность найденного материала;
- модель отвечает за следование инструкции, работу с контекстом и формат результата;
- прикладная логика проверяет обязательные поля и запрещает недопустимые действия;
- специалист заказчика утверждает правила корпоративного, юридического, кадрового или отраслевого учёта.
Не соединяйте подходы только потому, что каждый из них доступен. Если улучшенная инструкция устранила дефект формата, fine-tuning не обязателен. Если актуальный документ и настроенный поиск устранили фактическую ошибку, обучение на содержании регламента не становится необходимым.
Учебный пример двух ошибок корпоративного помощника
Ниже — синтетический пример для проектирования проверки, а не результат клиента или проведённого Switch On AI теста.
Учебный помощник выполняет две операции. Он отвечает на вопросы по новому регламенту и формирует карточку для сотрудника. Команда обнаружила два независимых дефекта:
- дефект A: ответ противоречит новой редакции регламента;
- дефект B: в карточке отсутствует обязательное поле «Основание».
Для дефекта A контрольный вопрос звучит так: «Кто согласует исключение по новому регламенту?» Эталон состоит из содержания разрешённого актуального документа и корректной ссылки на него. Сначала проверяют версию документа, права пользователя и результат поиска. Если нужный фрагмент найден, но модель исказила его, отдельно проверяют инструкцию работы с контекстом.
Для дефекта B эталон — карточка с обязательными полями «Тема», «Основание», «Ответственный» и «Следующий шаг» и правилами заполнения каждого поля. Первый эксперимент — уточнить инструкцию и добавить правильные примеры. Fine-tuning рассматривают только при устойчивом повторении ошибки и наличии достаточной обучающей выборки.
| Проблема | Предполагаемая причина | Первый эксперимент | Критерий | Следующий шаг |
|---|---|---|---|---|
| Неверный ответ по новому регламенту | В корпусе старая версия, неверные права или поиск не нашёл нужный фрагмент | Обновить корпус и проверить поиск по контрольному вопросу с правами пользователя | Не более 2 фактических ошибок из 20; каждый прошедший ответ содержит ссылку на разрешённый актуальный документ | Если фрагмент найден, но ответ неверен, проверить инструкцию работы с контекстом |
| Нарушен формат карточки | Неясная инструкция или недостаточно примеров | Уточнить схему полей и добавить эталонные карточки | Не более 1 дефектной карточки из 20 | Если ошибка устойчиво повторяется, подготовить данные и сравнить fine-tuning с базовой моделью |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
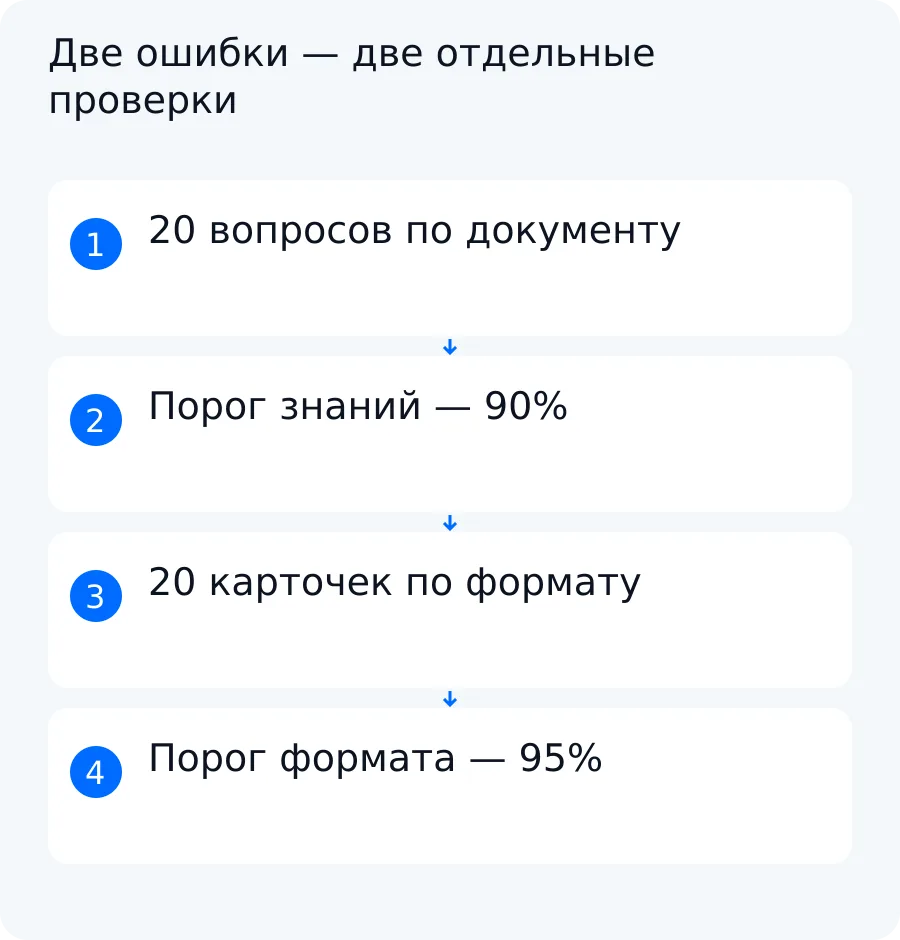
Синтетический набор содержит 40 заданий: 20 вопросов по регламенту и 20 заданий на формирование карточки. Эти группы нельзя объединять в один показатель.
Для вопросов по регламенту зададим N = 20 и допустим не более двух фактических ошибок. Доля корректных ответов вычисляется так:
(N − число ошибочных ответов) / N × 100%.
При двух ошибках пороговый результат равен (20 − 2) / 20 × 100% = 90%. Дополнительно каждый ответ должен ссылаться на разрешённый актуальный документ. Ответ без такой ссылки не проходит критерий источника, даже если формулировка похожа на эталон.
Для формата зададим N = 20 и допустим не более одной карточки с пропущенным, лишним или неверно оформленным обязательным полем. Доля карточек, прошедших проверку, равна:
(N − число дефектных карточек) / N × 100%.
При одной дефектной карточке результат равен (20 − 1) / 20 × 100% = 95%.
Это предложенные правила учебной приёмки, а не измеренный результат пилота. В рабочем проекте заказчик согласует допустимые ошибки по последствиям конкретной операции. Общий средний процент здесь не нужен: он скрыл бы различие между доступом к знаниям и соблюдением формата.
Как провести пилот и принять решение
До запуска пилота зафиксируйте:
- 40 заданий или другой согласованный объём без подмены примеров по ходу сравнения;
- отдельные группы для знаний и формата;
- версии корпуса, индекса, инструкции, модели и настроек;
- права тестовых пользователей и разрешённые источники;
- эталон для каждого задания;
- допустимые фактические ошибки и дефекты формата;
- способ фиксации найденных фрагментов, ответа и причины расхождения.
Затем сравните варианты поэтапно на одном наборе.
- Запустите базовую инструкцию и классифицируйте ошибки.
- Проверьте улучшенную инструкцию на всех затронутых заданиях.
- Для вопросов по документу проверьте RAG: сначала найденные фрагменты, затем итоговый ответ и ссылку.
- Если формат остаётся нестабильным и есть качественные примеры, подготовьте отдельную обучающую выборку и сравните fine-tuning с базовой моделью.
- Проверяйте гибрид только в том случае, если после раздельных экспериментов сохраняются обе задачи: получение актуального знания и устойчивое формирование результата.
Сохраняйте результаты по каждому заданию, а не только итоговый процент. Такая ведомость покажет, где возник дефект: в корпусе, правах, поиске, инструкции, поведении модели или проверке выходных данных.
Switch On AI может разобрать несколько неудачных ответов вместе с разрешёнными документами, определить первый проверяемый эксперимент и согласовать прототип одной операции. Компания разрабатывает ИИ-помощников и агентов после проверки данных, доступных API и прав. Прототип не означает полноценное внедрение, а совместимость конкретной платформы и условия эксплуатации проверяются отдельно.
Чтобы обсудить задачу, пришлите описание операции: два-три неудачных ответа, ожидаемый результат, разрешённые источники и критерий, по которому вы примете исправление.
Вопросы по этой задаче
Заменяет ли fine-tuning базу знаний?
Нет. Fine-tuning меняет поведение модели на обучающих примерах, но не гарантирует знание действующей редакции изменяемого документа. Для актуальных корпоративных фактов обычно нужен управляемый внешний корпус и проверяемый поиск.
Можно ли совместить RAG и дообучение?
Да, если проверка выявила две разные задачи. RAG может доставлять актуальный контекст, а дообученная модель — устойчиво обрабатывать его и формировать нужный результат. Каждую часть следует сначала оценить отдельно.
Когда достаточно хорошей инструкции?
Когда уточнённые правила и несколько эталонных примеров устраняют дефект на зафиксированном оценочном наборе. Если ошибка формата устойчиво повторяется, можно отдельно оценить целесообразность fine-tuning.