Владелец корпоративной базы знаний часто видит две противоположные ошибки. Сотрудник вводит код E17, но поиск поднимает похожие описания без нужного кода. Затем другой сотрудник спрашивает: «Почему устройство не набирает воду?» — и поиск не узнаёт формулировку из инструкции «нет подачи воды».
Один механизм трудно настроить одинаково хорошо для обоих случаев. Лексический поиск опирается на слова и точные обозначения, а векторный — на смысловую близость. Гибридный поиск RAG запускает оба вида retrieval, объединяет кандидатов и только после этого передаёт разрешённые фрагменты следующему этапу системы.
Ниже — способ спроектировать и проверить такой поиск на одном корпусе. Это руководство относится к стратегии поиска и ранжирования после подготовки документов. Оно не отвечает на соседний вопрос о выборе между RAG и дообучением; подготовку документов и владельцев данных стоит отдельно определить в руководстве по базе знаний.
Какую задачу решает этот процесс
Представим корпоративную инструкцию с кодами неисправностей и текстовыми пояснениями. Одни пользователи знают артикул или код и вводят его дословно. Другие описывают симптом своими словами. Поисковая система должна найти подходящий фрагмент в обоих случаях, сохранить сведения о его происхождении и не раскрыть документ без нужных прав.
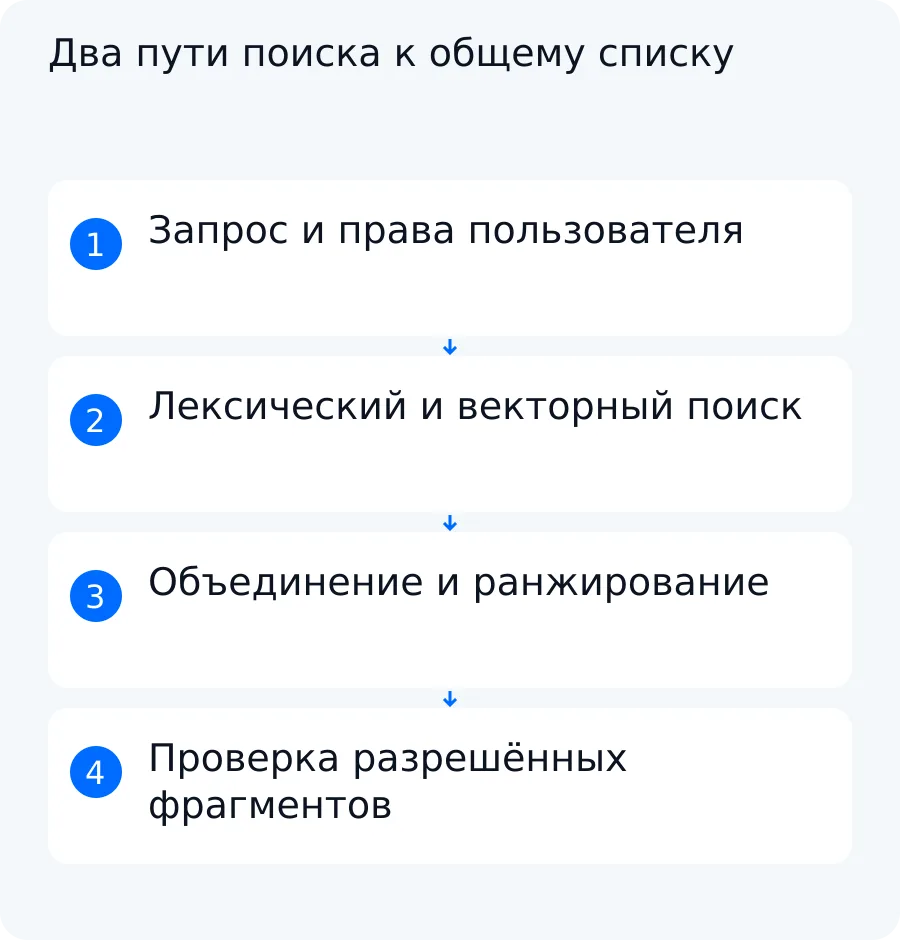
Процесс даёт не готовый ответ пользователю, а ранжированный набор фрагментов:
- система принимает запрос и сведения о правах пользователя;
- лексический и векторный поиск параллельно формируют списки кандидатов;
- система объединяет списки и при необходимости выполняет reranking;
- контроль прав исключает запрещённый текст до его передачи модели;
- генерация, если она предусмотрена, строит ответ только на разрешённых фрагментах.
Retrieval и генерация — разные этапы. Удачно сформулированный ответ не доказывает, что поиск нашёл правильное основание. И наоборот, найденный фрагмент ещё не гарантирует корректного ответа модели. Поэтому сначала оценивают выдачу поиска, а затем отдельно — итоговый ответ.
Какие данные и правила подготовить
Сравнение имеет смысл только при одинаковых исходных условиях. Для baseline и нового варианта используют один корпус, одинаковую разметку релевантности и один набор запросов. Иначе изменение результата нельзя связать с механизмом поиска.
Ниже — заполненный синтетический образец. Это не данные клиента, не готовый файл и не результат проведённого внедрения.
| Поле | Статус | Источник | Ответственный | Синтетический пример |
|---|---|---|---|---|
| Корпус | Обязательно | Утверждённые инструкции | Владелец базы знаний | Четыре фрагмента F1–F4 |
| Права | Обязательно | ACL или роли исходной системы | Владелец системы | Учебному пользователю доступны F1–F3, F4 закрыт |
| Фрагменты | Обязательно | Результат правил разбиения документов | Инженер поиска | Один законченный пункт инструкции на фрагмент |
| Точные коды | Обязательно | Поля и текст документов | Владелец контента | E17 и E18 |
| Текстовый индекс | Обязательно | Настройки поискового индекса | Инженер поиска | Поля code и text доступны для лексического поиска |
| Набор запросов | Обязательно | Обезличенные вопросы и сценарии проверки | Владелец процесса | «E17», «нет подачи воды» |
| Релевантные фрагменты | Обязательно | Экспертная разметка | Предметный эксперт | Для E17 ожидается F1 |
| Latency | Обязательно для приёмки | Журнал тестового стенда | Инженер | Допустимое значение пока не согласовано |
| Embeddings | Условно | Выбранная модель и построенный векторный индекс | Инженер поиска | Нужны, если применяется векторный retrieval |
| Модель embeddings, размер фрагмента, k, пороги, reranker | Неизвестно до обследования | Результаты будущего теста | Инженер и владелец процесса | Не подставлять произвольные значения |
| Возможности и права платформы | Неизвестно до проверки | Документация, тариф и API выбранной системы | Технический ответственный клиента | Проверить до проектирования интеграции |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Отдельно задают правило обновления: кто добавляет новую инструкцию, когда перестраиваются текстовый и векторный индексы и как старая версия перестаёт участвовать в выдаче. Без этого проверка быстро устареет, даже если первоначальный набор запросов пройден.
Для дальнейших примеров используем один синтетический корпус:
| ID | Доступ | Текст фрагмента |
|---|---|---|
| F1 | Доступен | E17: нет подачи воды. Проверьте кран и входной фильтр |
| F2 | Доступен | E18: вода не сливается |
| F3 | Доступен | Если устройство не набирает воду, убедитесь, что подача открыта |
| F4 | Закрыт для учебного пользователя | Сервисная процедура E17 |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
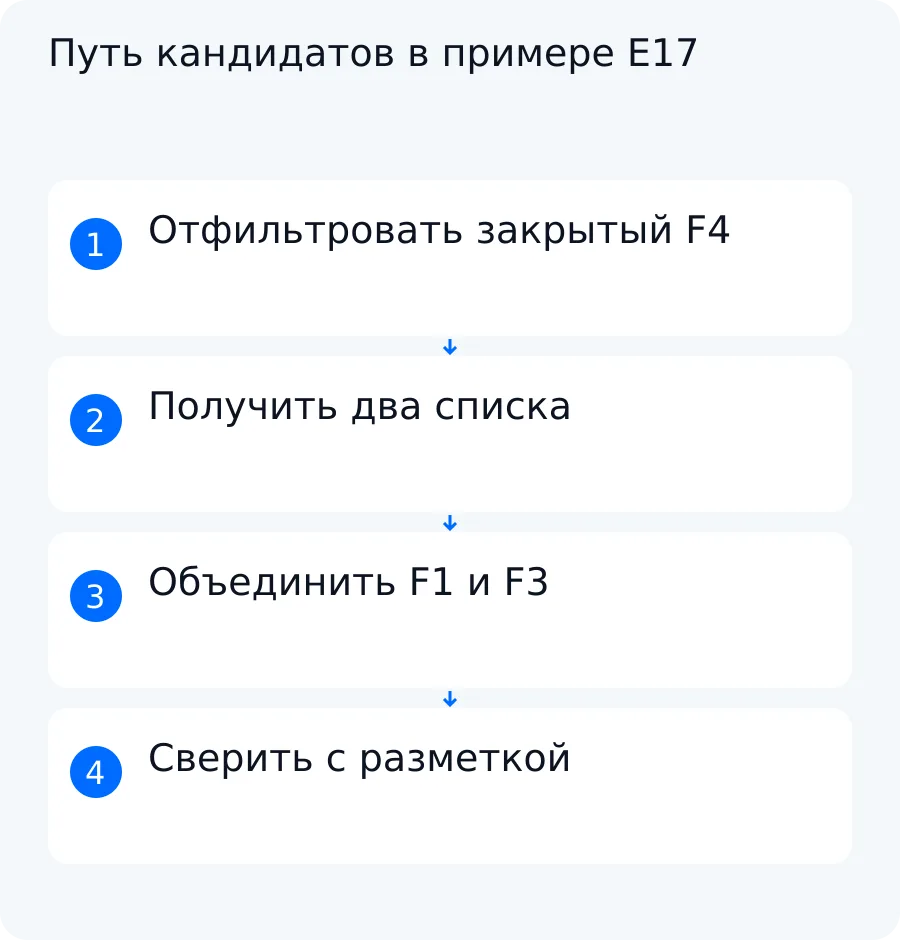
F4 нужен для проверки исключения. Его следует отсеять по правам до передачи текста модели. В вычисляемые учебные списки кандидатов для этого пользователя он не входит.
Чем лексический поиск отличается от векторного
Лексический поиск сравнивает термины запроса с текстовым индексом. BM25 и сходные функции учитывают совпавшие слова, их частоту и редкость в корпусе. Такой подход полезен для кодов, артикулов, имён и специальных обозначений. По запросу E17 ожидаемый учебный лидер — F1: в нём есть точное совпадение кода.
Векторный поиск преобразует запрос и фрагменты в embeddings и сравнивает их близость в выбранном векторном пространстве. Он способен связать формулировки «нет подачи воды» и «устройство не набирает воду», хотя они не совпадают дословно. Для вопроса «Почему устройство не набирает воду?» вероятным кандидатом будет F3, а в зависимости от модели — также F1.
Порядок здесь условный: модель embeddings не запускалась, поэтому статья не выдаёт предполагаемые позиции за измерение. Именно этот порядок предстоит проверить на выбранной модели и корпусе.
| Подход | Что использует | Сильная сторона | Ограничение в нашем примере |
|---|---|---|---|
| Лексический | Слова, коды и текстовый индекс | Находит точное E17 | Может слабо связать разные формулировки одного симптома |
| Векторный | Embeddings и меру близости | Находит смысловые перефразирования | Редкий код может потерять значение или получить неверного соседа |
| Гибридный | Оба списка кандидатов | Сохраняет точные и смысловые совпадения | Нужны правила объединения и собственная проверка качества |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Один метод не закрывает оба случая автоматически. Векторная близость не гарантирует сохранения артикула, а совпадение слов не гарантирует совпадения смысла.
Есть и другие варианты: фильтры по метаданным, поиск по отдельному полю кода, словари синонимов, нечёткое сопоставление, граф связей или внешний поисковый API. Их выбирают по структуре данных и ошибкам baseline. Упоминание варианта не означает наличия готового коннектора: API, тариф, права, версия и ограничения конкретной платформы проверяются отдельно.
Как объединить кандидатов и ранжировать
Гибридный retrieval обычно формирует два ранжированных списка параллельно. Их исходные оценки нельзя без проверки просто сложить: шкала BM25 отличается от шкалы векторной близости. Reciprocal Rank Fusion, или RRF, использует позиции кандидатов, а не пытается приравнять исходные баллы.
Для документа d учебная формула выглядит так:
RRF(d) = Σ 1 / (K + rank_i(d))
Здесь rank_i(d) — позиция документа в каждом списке, а K — параметр формулы. Официальная документация Azure AI Search описывает параллельный полнотекстовый и векторный поиск с объединением через RRF. Она также описывает расчёт 1 / (rank + k). Это подтверждает механизм данной платформы, но не свойства других продуктов.
Покажем арифметику на условных рангах для запроса E17 после фильтра прав. Возьмём K = 60 только для учебного расчёта.
| Фрагмент | Лексический ранг | Векторный ранг | Расчёт | RRF после сложения |
|---|---|---|---|---|
| F1 | 1 | 2 | 1/61 + 1/62 | 0,032522 |
| F3 | 3 | 1 | 1/63 + 1/61 | 0,032266 |
| F2 | 2 | 3 | 1/62 + 1/63 | 0,032002 |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Итоговый порядок: F1, F3, F2. Значения округлены после сложения. Параметр 60 не следует переносить как универсальную настройку: состав корпуса, длина списков и критерии качества отличаются.
После объединения можно применить reranking к короткому списку. Этот этап повторно оценивает кандидатов относительно запроса и меняет их порядок. Он добавляет вычисления и задержку, поэтому нужен не по умолчанию, а при выполнении двух условий: размеченный набор показывает улучшение относительно baseline, а latency остаётся в согласованной границе. Модель reranker, размер списка и порог — параметры будущего теста.
Как проверить качество гибридного поиска
Начните с небольшого набора реальных типов вопросов, но обезличьте их и заранее укажите ожидаемые фрагменты. Предметный эксперт должен разметить ответы до просмотра результатов новой настройки: так оценка меньше зависит от желания подтвердить уже выбранное решение.
Синтетический набор для нашего корпуса:
| Запрос | Ожидаемые релевантные фрагменты | Что проверяем |
|---|---|---|
| E17 | F1 | Сохранилось точное совпадение кода |
| нет подачи воды | F1 | Найдена формулировка инструкции |
| устройство не набирает воду | F3 и допустимо F1 | Найдено перефразирование и связанный фрагмент |
| вода не сливается | F2 | Симптом не спутан с подачей воды |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Для одного запроса Recall@k считают так:
Recall@k = число релевантных фрагментов в первых k результатах / общее число размеченных релевантных фрагментов.
Допустим, для запроса «устройство не набирает воду» эксперт заранее отметил F1 и F3. Если синтетический baseline BM25 в первых двух позициях вернул F3 и F2, то Recall@2 = 1/2 = 0,5. Если гибридный вариант вернул F3 и F1, то Recall@2 = 2/2 = 1,0.
Это воспроизводимый пример расчёта, а не проведённый тест и не доказательство ожидаемого эффекта на рабочей базе. В проекте нужно заменить условные списки фактической выдачей на одном корпусе.
Одной метрики недостаточно. При ручной оценке проверьте:
- действительно ли найденный фрагмент отвечает на запрос;
- сохранился ли точный код там, где он важен;
- не вытеснил ли похожий по теме текст нужную инструкцию;
- можно ли открыть источник и проверить контекст;
- не попал ли в кандидаты документ без прав;
- приемлема ли задержка относительно согласованного baseline.
Права нельзя оценивать только по качеству итогового ответа. Сначала система ограничивает доступный набор, затем выполняет retrieval и передаёт модели только разрешённый текст. Если архитектура выбранной платформы требует другого порядка, нужно отдельно доказать, что закрытый текст не оказывается в контексте модели или ответе пользователя.
Учебный пример: путь от входных данных до результата
Ниже показана документированная учебная последовательность на синтетическом корпусе F1–F4. Она не является снимком интерфейса, клиентским кейсом или результатом запуска конкретной поисковой системы.
Входные данные — четыре фрагмента, роль учебного пользователя и два запроса. F4 закрыт этой ролью и исключается. Затем лексический и векторный механизмы создают свои списки, объединение сохраняет источник каждого кандидата, а проверка сравнивает выдачу с заранее размеченными ожиданиями.
| Запрос | Лексический результат | Векторный результат | Объединение | Проверка |
|---|---|---|---|---|
| E17 | F1 | F3, затем F1 — условно | F1 и F3; для каждого отмечен источник списка | F1 содержит точный код; F4 исключён правами |
| Почему устройство не набирает воду? | F3, затем F1 — условно | F3, затем F1 — условно | F3 и F1 | Оба фрагмента относятся к подаче воды; F2 нерелевантен |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Первый запрос показывает роль точного совпадения. В инструкции встречается код E17 и описание «нет подачи воды», поэтому лексический механизм поднимает F1. Второй запрос показывает роль смыслового поиска: формулировка пользователя ближе к F3, но F1 тоже может быть полезен как инструкция по той же проблеме.
Таблица не утверждает, что неизвестная модель обязательно расставит кандидатов именно так. Это ожидаемый порядок, который превращают в проверяемое условие. После выбора embeddings, параметров индекса и reranker инженер сохраняет фактические списки, а эксперт сравнивает их с разметкой.
Происхождение кандидата важно для диагностики. Если F1 пришёл только из лексического списка, а F3 — только из векторного, видно, какую потерю вызовет отключение одного канала. Если кандидат пришёл из обоих списков, RRF учтёт обе позиции. Если F4 появился хотя бы в одном доступном модели контексте, проверка прав провалена независимо от качества остальных результатов.
Как проверить результат перед запуском
Перед запуском полезно пройти не только нормальный путь, но и исключение. Ожидаемый результат, сигнал ошибки и действие человека фиксируют до проверки.
| Сценарий | Ожидаемый результат | Сигнал ошибки | Действие человека |
|---|---|---|---|
| Запрос по доступной инструкции | Для E17 найден F1; для смыслового вопроса найдены F3 и допустимый F1 | Нужного фрагмента нет в top-k либо ответ не опирается на него | Проверить разметку, разбиение, индекс, параметры retrieval и reranking |
| Запрос пользователя без права на F4 | Текста F4 нет среди доступных кандидатов и в промпте модели | Идентификатор или текст F4 попал в контекст модели | Остановить выпуск, проверить ACL и порядок фильтрации, затем повторить затронутые проверки |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Контрольный список перед запуском:
- retrieval не назван генерацией и оценивается отдельно от ответа модели;
- лексический, векторный и гибридный варианты используют один корпус;
- релевантные фрагменты размечены до сравнения;
- формула RRF и её область применения подтверждены документацией выбранной платформы;
- учебный расчёт не выдан за измерение рабочего решения;
- baseline и новый вариант сравниваются на одном наборе запросов;
- права применяются так, чтобы запрещённый фрагмент не попал в промпт;
- для изменений корпуса, модели или правил доступа предусмотрен повтор соответствующих проверок.
Прохождение одного запроса не подтверждает готовность системы. Решение принимают по всему согласованному набору, включая точные коды, перефразирования, нерелевантные совпадения и запрет доступа.
Что согласовать для внедрения
Готовый поисковый инструмент может уже поддерживать полнотекстовый и векторный поиск, RRF, фильтры или reranking. Но наличие каждой функции зависит от платформы, версии, тарифа, API и прав клиента. Документация Azure AI Search подтверждает собственный механизм гибридного запроса и RRF; она не доказывает совместимость с вашей системой и не подтверждает выполненный проект Switch On AI.
Собственная интеграция нужна, когда требуется связать источники документов, роли пользователей, индексы, журнал проверок и интерфейс рабочего процесса. До выбора реализации нужно согласовать:
- какой корпус входит в первую проверку и кто им владеет;
- где хранятся коды, текст и ACL;
- какие вопросы существующий поиск обрабатывает неверно;
- что считается релевантным фрагментом и кто утверждает разметку;
- какой baseline используется;
- какие значения Recall@k и latency допустимы;
- требуется ли reranker по результатам сравнения;
- какой текст можно передавать модели и внешним сервисам;
- что делает сотрудник при отсутствии ответа или нарушении прав.
Switch On AI может разработать ИИ-помощника, бота или интеграцию для этой операции после проверки данных и API. Формат зависит от поведения решения: диалоговый канал сам по себе не делает систему агентом, а фиксированная передача запроса между сервисами может остаться обычной интеграцией.
Задача такого проекта формулируется конкретно: точные артикулы и смысловые запросы проверяются разными механизмами поиска, а человеку видны источники кандидатов и результаты контрольных запросов. Правила бухгалтерского, юридического, кадрового и отраслевого учёта, если они затронуты документами, задаёт и проверяет специалист заказчика.
Первый шаг — показать несколько вопросов, на которых существующий поиск ошибается, и ожидаемые фрагменты для каждого. По ним можно разобрать одну операцию, проверить доступные данные и API и согласовать границы прототипа. Прототип не равен полному внедрению и не подтверждает заранее сроки или эффект. Чтобы обсудить исходные примеры и критерии приёмки, свяжитесь со Switch On AI.
Вопросы по этой задаче
Когда векторного поиска недостаточно?
Когда запрос содержит точный код, артикул, имя или другой редкий идентификатор, смысловая близость может не сохранить нужное совпадение. Такие запросы проверяют лексическим поиском, а в гибридном варианте объединяют его кандидатов с векторными.
Нужен ли reranker?
Не всегда. Его стоит добавлять, если на размеченном наборе он улучшает результат относительно baseline и сохраняет приемлемую задержку. Модель, размер списка и порог определяют по тесту на конкретном корпусе.
Как проверить улучшение поиска?
Использовать один корпус и один заранее размеченный набор запросов для baseline и гибридного варианта. Затем сравнить Recall@k, ручную релевантность, сохранение точных кодов, задержку и отсутствие закрытых фрагментов в контексте модели.