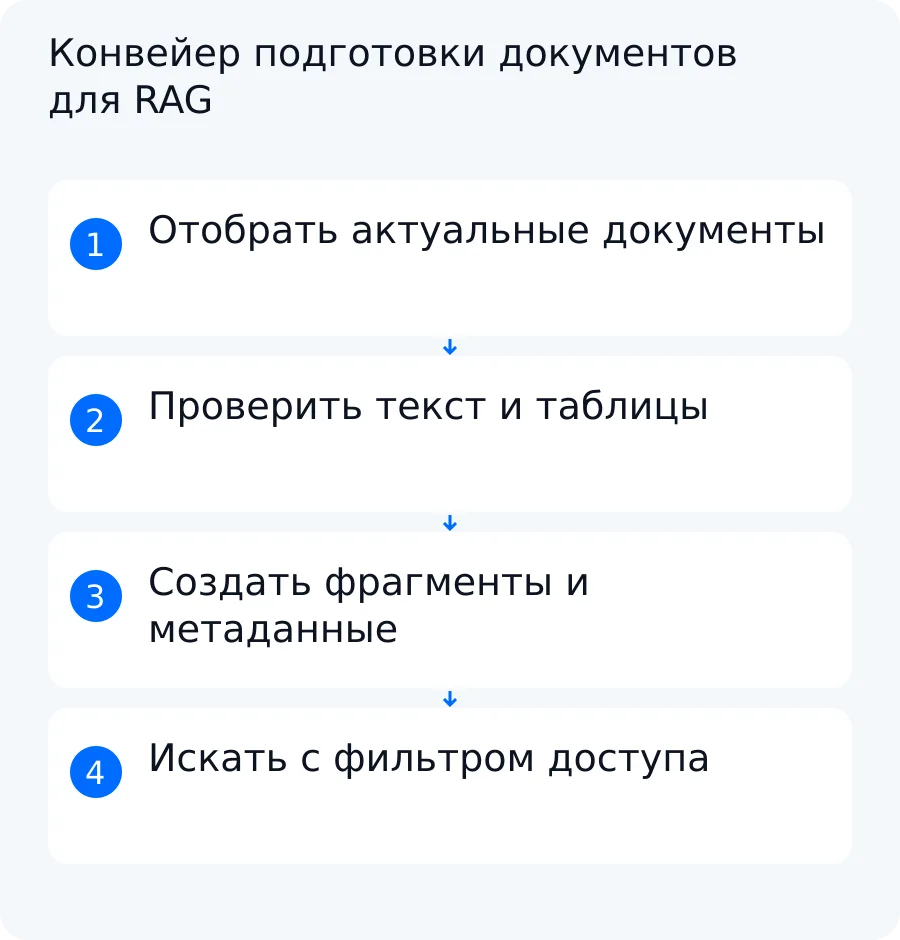
Работа с документами в RAG начинается не с выбора модели, а с управляемого корпуса. Если в него одновременно попали две версии регламента, таблица потеряла единицы измерения, а права остались только текстовой пометкой, поиск может вернуть неподходящий фрагмент. Модель затем составит убедительный ответ на неверном основании.
Владелец базы знаний может снизить этот риск до внедрения: назначить владельцев документов, исключить дубликаты и старые версии, проверить извлечение, сохранить источник и доступ, а затем испытать поиск на заранее составленных вопросах. Это не устраняет все ошибки генерации, но делает найденное основание ответа проверяемым.
Если сначала нужно определить назначение и состав корпоративной базы, начните с руководства по базе знаний. Здесь разберём более узкую задачу: подготовку документов для RAG.
Почему качество RAG начинается с документов
В типичном RAG-конвейере система получает вопрос, ищет подходящие фрагменты и передаёт их модели как контекст. Ошибка на раннем этапе проходит дальше по цепочке:
- В корпус загрузили старую и новую редакции инструкции.
- Поиск нашёл старую редакцию, потому что её формулировка ближе к вопросу.
- Модель сформировала ответ по найденному тексту.
- Пользователь увидел связный, но устаревший ответ.
Такая проблема не сводится к embedding или модели. Сначала нужно проверить сам корпус: какие документы в него входят, кто отвечает за их актуальность, можно ли их использовать и сохранился ли смысл после извлечения.
Важно разделять три слоя:
- Подготовка корпуса отвечает за состав, качество текста, версии, источник и права. Она помогает поиску получить подходящий материал.
- Модель формирует ответ по найденному контексту. Даже при чистом корпусе она может неправильно истолковать текст или добавить лишнее, поэтому ответы всё равно нужно проверять.
- Память агента хранит состояние взаимодействия: например, ранее заданный вопрос или выбранный проект. Она не заменяет реестр документов и не определяет, какая редакция регламента действует.
Поэтому обещание «очистим документы — и галлюцинаций не будет» некорректно. Подготовка данных RAG устраняет часть известных причин неправильного поиска, но качество ответа зависит также от запроса, способа поиска, модели, инструкций и критериев остановки.
Как отобрать документы и назначить владельцев
Начните не с массовой загрузки, а с реестра кандидатов. Одна строка реестра должна объяснять, почему файл включён или отклонён. Для каждого документа проверьте четыре условия.
Актуальность. Зафиксируйте версию, дату действия и статус. Дата изменения файла не всегда равна дате вступления документа в силу, поэтому правило выбора подтверждает владелец процесса.
Права. Уточните, кому принадлежит материал и можно ли использовать его в выбранной системе. Возможность открыть файл сотрудником не означает автоматического разрешения передавать его внешнему сервису.
Область использования. Определите, для каких подразделений, вопросов и групп предназначен документ. Конфиденциальный регламент не должен становиться общим источником только потому, что его удобно индексировать.
Повторяющиеся версии. Сравните document_id, заголовок, дату действия и содержание. Файлы с разными именами могут оказаться копиями, а одинаковые имена — разными редакциями.
Минимальный рабочий реестр может выглядеть так:
| document_id | Заголовок | Версия | Статус | Источник | Разрешённые группы | Владелец | Причина включения или отклонения |
|---|---|---|---|---|---|---|---|
| REG-01 | Регламент контроля раствора | 2.0 | Включён | approved/reg-01-v2.pdf | service_team | Руководитель службы | Действует с 2026-01-15 |
| REG-01 | Регламент контроля раствора | 1.0 | Отклонён | archive/reg-01-v1.pdf | service_team | Руководитель службы | Заменён версией 2.0 |
| TAB-01 | Пределы показателей | 1.0 | Включён после проверки | approved/limits.xlsx | service_team | Инженер процесса | Единицы и заголовки извлечены без потери смысла |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Это синтетические учебные данные, а не документы клиента и не результат внедрения Switch On AI.
Не удаляйте отклонённую строку из реестра. Она объясняет, почему файл не попал в поиск, и помогает не загрузить его снова при следующем обновлении. Сам файл можно хранить по правилам заказчика вне поискового корпуса.
Как извлечь и очистить текст без потери смысла
Извлечение нужно проверять сравнением с оригиналом. Это особенно важно для сканов, сложных PDF и электронных таблиц. Просмотрите не только начало документа, но и страницы с таблицами, примечаниями, переносами и предупреждениями.
OCR и кодировки
После OCR проверьте символы, которые меняют значение: десятичные разделители, минусы, знаки сравнения, номера пунктов, латинские и кириллические буквы. Последовательность «25 мг/л» нельзя считать успешно извлечённой, если на выходе осталось только «25».
Для текстовых файлов проверьте кодировку и управляющие символы. Искажённые буквы ухудшают как обычный, так и векторный поиск: запрос пользователя может не совпасть с испорченным термином.
Колонтитулы и повторяющийся шум
Номера страниц, название компании и отметка о конфиденциальности могут повторяться на каждой странице. Их можно вынести из текста фрагмента в метаданные, если они не меняют смысл. Но предупреждение «только для сервисной группы» нельзя удалять как обычный колонтитул, пока его роль не определена владельцем.
Списки, таблицы и примечания
Список должен сохранять связь между вводной фразой и пунктами. В таблице каждой величине нужны заголовок строки, заголовок столбца и единица. Если ячейка «25 мг/л» отделилась от строки «Предельная концентрация», фрагмент стал двусмысленным.
Практическое правило: удаляйте только то, что признано шумом. Сохраняйте определения, условия применения, исключения, предупреждения, единицы и примечания. После очистки задайте вопрос по спорному месту и убедитесь, что человек может ответить, читая только полученный фрагмент и его метаданные.
Как выбрать границы фрагментов
Chunk — это часть документа, которую поиск рассматривает как отдельную единицу. Слишком крупный фрагмент смешивает несколько тем. Слишком мелкий может потерять условие, заголовок или расшифровку показателя. Единого размера для всех корпусов нет.
Есть три основных подхода.
| Подход | Как работает | Сильная сторона | Риск |
|---|---|---|---|
| По структуре | Делит по заголовкам, разделам, абзацам и строкам таблицы | Сохраняет устройство документа | Один раздел может оказаться слишком большим или слишком коротким |
| По размеру | Делит по числу символов или токенов, иногда с перекрытием | Даёт предсказуемый предел для обработки | Граница может пройти между условием и значением |
| По смыслу | Объединяет предложения и абзацы в смысловые блоки | Лучше удерживает связанный контекст | Требует отдельной проверки качества и повторяемости |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Документация Microsoft Azure AI Search описывает фиксированное, структурное, смысловое и комбинированное разбиение. В ней также приведены стартовые параметры для отдельных сценариев. Эти числа относятся к документированному продукту и служат отправной точкой эксперимента, а не универсальной нормой.
Для регламентов разумно сначала использовать структуру: заголовок раздела, условие, правило, исключение и связанное примечание держать вместе. Ограничение по размеру применяйте как второй уровень. Если раздел приходится делить, повторите в дочерних фрагментах document_id, заголовок документа и заголовок раздела. Перекрытие добавляйте только там, где оно помогает сохранить связь, иначе оно создаст лишние почти одинаковые результаты.
Проверяйте несколько вариантов на одинаковом наборе вопросов. Для поиска можно заранее определить метрику:
recall@k = число вопросов, для которых нужный фрагмент найден в top-k / общее число проверочных вопросов
Формула задаёт способ оценки, но не доказывает качество конкретного корпуса. Значение можно публиковать только после запуска на зафиксированной выборке с указанными параметрами поиска.
Какие метаданные и ограничения доступа сохранить
Минимальный набор метаданных помогает найти источник, обновить корпус и объяснить результат:
document_id— устойчивый идентификатор документа;chunk_id— идентификатор фрагмента;versionи дата действия — основание для выбора редакции;titleи заголовок раздела — контекст фрагмента;source— путь или иной проверяемый указатель на оригинал;owner— человек или роль, которые подтверждают содержание;allowed_groups— группы, которым разрешён документ;status— включён, отклонён, на проверке или выведен из корпуса.
Поле доступа и реальное ограничение — разные вещи. Запись allowed_groups = [service_team] сама по себе ничего не запрещает. Приложение должно получить группы пользователя и применить фильтр до передачи результатов модели. Логическое условие можно выразить так:
allowed_groups документа ∩ groups пользователя ≠ ∅
Если пересечение пусто, документ не должен участвовать в выдаче. Запрет в системном промпте не заменяет такой фильтр: к моменту генерации закрытый текст уже мог попасть в контекст.
В официальной документации Microsoft Azure AI Search описаны фильтры безопасности и несколько вариантов документного контроля доступа. Часть встроенных механизмов помечена как preview. Поэтому для проекта отдельно проверяют источник данных, модель идентификации, версию API или SDK, права и статус выбранной возможности. Статья не утверждает совместимость с системой конкретного заказчика и не заменяет такую проверку.
Учебный пример очистки регламента и таблицы
Ниже — синтетический пример. Он показывает логику подготовки, но не является клиентским кейсом, файлом Switch On AI или результатом живого теста.
В наборе три элемента:
REG-01, версия 2.0, действует с 2026-01-15;REG-01, версия 1.0, действует с 2024-06-01 и заменена новой;TAB-01, где для учебного показателя записан предел 25 мг/л.
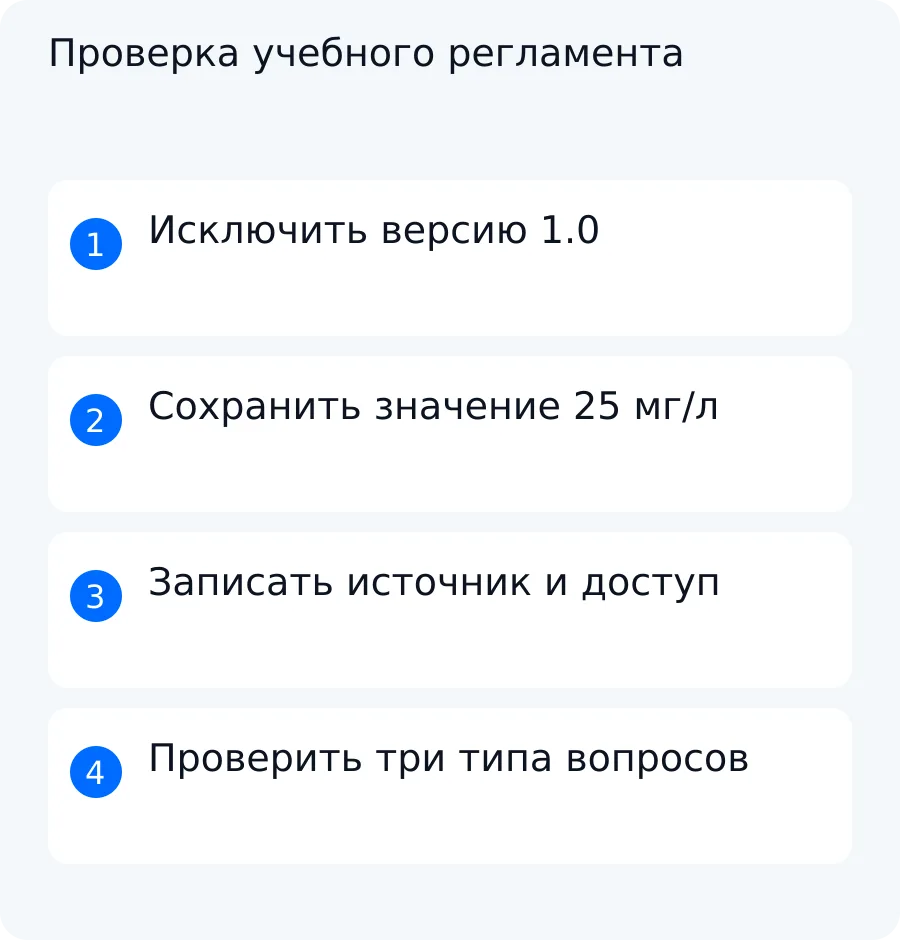
Правило отбора в этом учебном примере: владелец процесса подтвердил версию 2.0 как действующую, а версию 1.0 — как заменённую. Одной максимальной даты недостаточно: будущая или неутверждённая редакция тоже может иметь более позднюю дату. Здесь даты подтверждают выбор владельца:
2026-01-15 > 2024-06-01
Поэтому версия 2.0 входит в корпус, а версия 1.0 остаётся в реестре со статусом «отклонена» и причиной «заменена версией 2.0».
Исходный дефект
После неудачного извлечения заголовок строки и единица отделились от значения:
Предел — 25
По такому фрагменту нельзя понять, о каком показателе идёт речь и в каких единицах указан предел. Значение нельзя безопасно использовать в ответе.
Корректный фрагмент
После сверки с синтетической исходной таблицей фрагмент сохраняет заголовок, условие и единицу:
Регламент контроля раствора — раздел «Предельная концентрация». Для учебного показателя при штатной проверке: предел — 25 мг/л. Источник: REG-01, версия 2.0; связанная таблица TAB-01. Доступ: service_team.
Сводная таблица связывает документ, фрагмент и проверку:
| Документ | Версия | Фрагмент | Метаданные | Проверочный вопрос |
|---|---|---|---|---|
| REG-01 — Регламент контроля раствора | 2.0, действует с 2026-01-15 | «Предельная концентрация… предел — 25 мг/л» | document_id: REG-01; source: approved/reg-01-v2.pdf; allowed_groups: service_team; статус: включён | Каков предел и в каких единицах он указан? |
| REG-01 — Регламент контроля раствора | 1.0, действует с 2024-06-01 | В поисковый корпус не передаётся | document_id: REG-01; source: archive/reg-01-v1.pdf; статус: отклонён; причина: заменён версией 2.0 | Не должна ли старая редакция появляться в результатах? |
| TAB-01 — Пределы показателей | 1.0 | Строка показателя с заголовком и значением «25 мг/л» | source: approved/limits.xlsx; allowed_groups: service_team; статус: включён после проверки извлечения | Сохранились ли название показателя и единица? |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Для пользователя из service_team ожидаемый учебный ответ на первый вопрос — «25 мг/л» с указанием REG-01, версии 2.0. Пользователю без этой группы поиск не должен возвращать данный фрагмент. Если единица потеряна или найдена только версия 1.0, проверка не пройдена.
Пример показывает две независимые защиты. Реестр не даёт старой копии конкурировать с новой, а фрагмент сохраняет смысл таблицы. Ни одна из них не заменяет фильтр доступа при запросе.
Как проверить поиск и обновлять корпус
Проверку поиска готовят до обсуждения красивого ответа модели. Для каждого вопроса зафиксируйте ожидаемый документ, подходящий фрагмент, допустимые группы и поведение при нехватке данных.
В набор должны входить три типа вопросов.
| Тип проверки | Пример | Ожидаемое поведение |
|---|---|---|
| Ответ есть и доступ разрешён | «Каков предел и в каких единицах он указан?» от участника service_team | Найдена версия 2.0; в основании есть 25 мг/л и источник |
| Ответа в корпусе нет | «Кто утвердил исключение для ночной смены?», если таких сведений нет | Система сообщает о нехватке данных, а не придумывает имя или правило |
| Ответ есть только в закрытом документе | Тот же вопрос от пользователя без группы service_team | Закрытый фрагмент не участвует в выдаче; содержание не раскрывается |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Отдельно проверьте старую формулировку из версии 1.0, запрос без точных терминов, вопрос к строке таблицы и запрос, который требует связать заголовок с примечанием. Сравнивайте найденные фрагменты, а не только гладкость итогового ответа.
После изменения источника не обновляйте индекс вслепую. Владелец документа подтверждает новую редакцию, запись реестра меняет статус, корпус переиндексируется, а затронутые вопросы выполняются повторно. Сохраняйте дату обновления, состав корпуса и параметры проверки, чтобы отличить изменение документов от изменения поиска или модели.
Для первого прототипа не нужен весь архив компании. Можно выбрать одну операцию и небольшой разрешённый корпус: несколько действующих регламентов, типовые вопросы сотрудников и примеры отсутствующего или запрещённого ответа. Критерии приёмки стоит согласовать заранее:
- актуальная версия находится по контрольным вопросам;
- устаревшая копия не участвует в поиске;
- заголовки, условия, предупреждения и единицы сохраняются;
- каждый найденный фрагмент содержит источник и версию;
- фильтр доступа применяется при поиске;
- при отсутствии основания система сообщает о нехватке данных.
Switch On AI может помочь описать такую операцию и разработать ИИ-помощника, бота или интеграцию после проверки данных, доступных API и прав. Если путь к ответу меняется в зависимости от запроса, можно рассмотреть разработку ИИ-агента. Если достаточно фиксированного поиска и передачи результата, агентный подход может не понадобиться.
Чтобы обсудить прототип, передайте обезличенный регламент и типовые вопросы сотрудников. На разборе можно согласовать один корпус, правила доступа и проверочные вопросы без обещания совместимости или результата до проверки вашей системы.
Вопросы по этой задаче
Нужны ли одинаковые размеры всех фрагментов?
Нет. Границы выбирают по структуре, смыслу, ограничениям используемых моделей и контрольным вопросам. Числовые параметры из документации можно взять как старт эксперимента, но итоговый вариант проверяют на собственном корпусе.
Как обрабатывать таблицы?
Сохраняйте вместе название показателя, заголовки строки и столбца, значение, единицу и важное примечание. После извлечения задайте вопрос по строке и проверьте, что ответ можно получить из одного фрагмента без догадки.
Нужно ли загружать устаревшие регламенты?
Не следует включать их в рабочий поисковый корпус наравне с действующей версией. Оставьте запись в реестре со статусом «отклонён» и причиной, чтобы сохранить историю решения и не загрузить старую копию повторно.