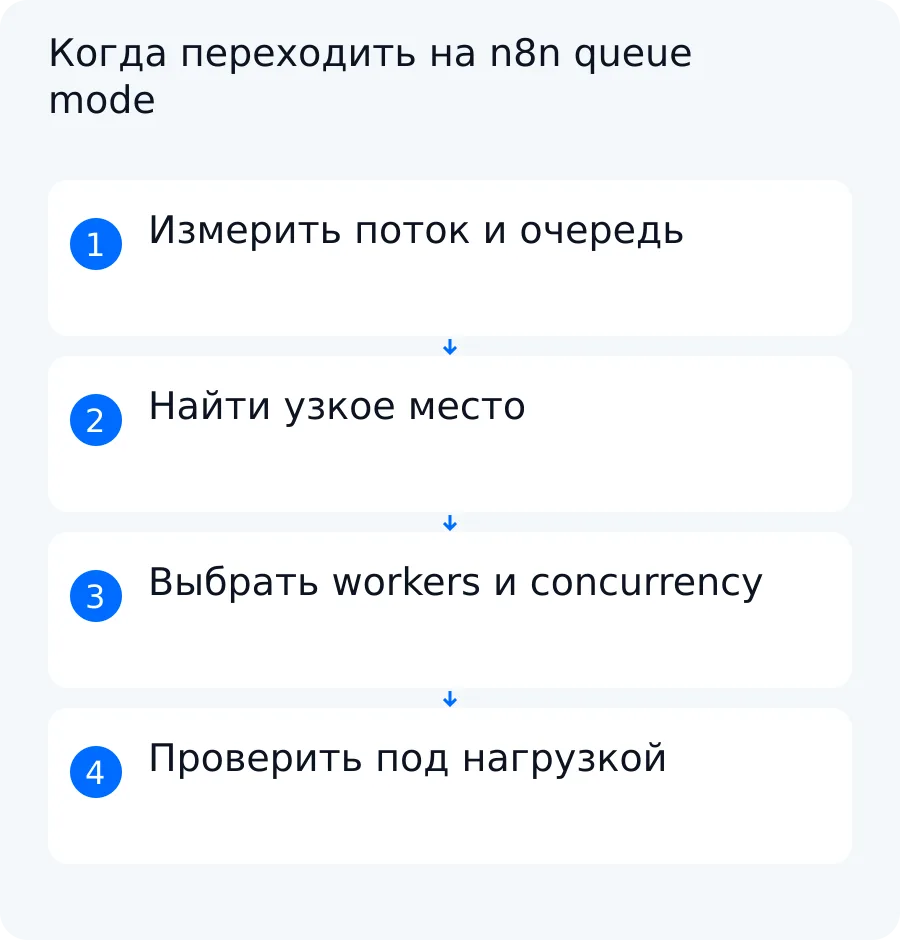
Владелец нагруженной автоматизации видит, что задания стали ждать дольше, но ещё не знает причину. Добавление workers поможет только тогда, когда задержка связана с доступной для распараллеливания обработкой. Если предел задаёт Postgres, память или внешний API, новые процессы могут лишь перенести узкое место.
Поэтому решение о n8n queue mode начинается с замера. Сравните входную и завершённую интенсивность, длительность executions, возраст очереди, CPU, память, состояние Postgres и ответы внешних сервисов. Затем проверьте queue mode нагрузочным сценарием. Это способ повысить общую пропускную способность и распределить независимые исполнения, а не средство разделить workflow на подпроцессы или настроить отдельный тайм-аут.
Какую задачу решает этот процесс
Queue mode отделяет приём и планирование задания от его выполнения. Main создаёт execution, Redis передаёт его доступному worker, а worker получает сведения из базы данных и исполняет workflow. Несколько workers могут одновременно обрабатывать независимые задания.
Перед изменением архитектуры зафиксируйте исходную картину:
- Измерьте входную интенсивность λ и завершённую интенсивность μ за один период.
- Снимите p95 длительности execution, CPU, память, соединения и задержки Postgres.
- Запишите глубину очереди Q, возраст старейшего задания A и ошибки внешнего API.
- Определите ограничение и только после этого выбирайте число workers и concurrency.
Если λ больше μ, а Q или A устойчиво растут, система не успевает обрабатывать поток. Но это ещё не доказывает, что ей не хватает workers. Например, четыре параллельных исполнения могут одновременно упереться в лимит внешнего API и увеличить число ошибок.
Queue mode не обещает ускорить один последовательный workflow. Его шаги по-прежнему зависят друг от друга. Для декомпозиции большой схемы предназначен отдельный разбор модульной структуры workflow.
Какие данные и правила подготовить
До проектирования соберите один паспорт конфигурации. Источником служат не воспоминания участников, а текущая конфигурация, система секретов, параметры базы и наблюдаемые метрики. Значения ниже — заполненный синтетический образец, а не конфигурация клиента и не универсальная рекомендация.
| Поле | Условное значение | Обязательность | Источник | Ответственный |
|---|---|---|---|---|
| Версия n8n | Неизвестно: уточнить перед проектированием | Обязательное; значение пока неизвестно | Реестр развёртываний и запущенный образ | Администратор n8n |
| Режим executions | queue | Обязательное | Конфигурация main и workers | Администратор n8n |
| Redis | Отдельный доступный экземпляр | Обязательное для queue mode | Конфигурация подключения и мониторинг | DevOps |
| База данных | Postgres; версию сверить с документацией выбранной n8n | Обязательное | Параметры СУБД и реестр инфраструктуры | DBA |
| Workers | 2 | Обязательное для учебного примера | Описание развёртывания | DevOps |
| Concurrency | 2 на worker | Условное проектное значение | Параметры запуска и план нагрузочной проверки | Архитектор |
| Ключ шифрования | Одно согласованное значение для main, workers и webhook processors | Обязательное | Система секретов без раскрытия значения | Владелец секретов |
| Binary data | Совместимое общее хранилище | Условное: нужно при работе с файлами или выбранном offload | Карта потоков данных и конфигурация хранения | Архитектор |
| Метрики очереди | Q, A и число ошибок | Обязательное эксплуатационное правило | Система мониторинга | SRE или дежурный инженер |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
«Уточнить» — допустимое состояние при первичном сборе, но не перед запуском. Версия влияет на доступные параметры. Редакция, тариф и права влияют на доступность отдельных функций наблюдения и хранения. Эти условия проверяют для конкретного размещения.
Секреты не копируют в рабочую таблицу. В ней указывают безопасное имя секрета, владельца и способ сверки. Значение общего ключа должно быть доступно нужным компонентам через согласованный механизм управления секретами.
Как queue mode разделяет приём и исполнение
Документированная последовательность для self-hosted n8n выглядит так:
- Main принимает триггер или webhook и создаёт execution, но не выполняет его рабочие шаги.
- Redis хранит очередь ожидающих execution ID.
- Свободный worker получает ID и читает сведения о workflow из общей базы данных.
- После исполнения worker записывает результат в базу и сообщает о завершении через Redis.
Postgres в этой схеме хранит состояние executions, а Redis работает как брокер очереди. Поэтому каждому worker нужны соединения и с Redis, и с базой. Общий ключ шифрования нужен main, workers и подключённым webhook processors, чтобы они могли работать с сохранёнными учётными данными.
Если входящие webhook-запросы сами становятся узким местом, архитектура может включать отдельные webhook processors и балансировщик. Они принимают запрос, а фактическое исполнение всё равно передают worker. Main не следует автоматически включать в webhook-пул: конкретную маршрутизацию сверяют с документацией и версией развёртывания.
Собственная схема процесса, не снимок интерфейса:
- Входящий запрос поступает в main или выбранный webhook processor.
- Компонент создаёт execution и передаёт его ID в Redis.
- Worker получает ID, читает состояние из Postgres и выполняет операцию.
- Worker сохраняет результат; внешняя система связывает действие с idempotency key.
Queue mode добавляет передачу между компонентами. Для webhook это может дать дополнительную задержку отдельного запроса. Выгода оценивается по общей пропускной способности под нагрузкой, а не по обещанию ускорить каждое выполнение.
Как выбрать concurrency и ресурсы
Worker — отдельный процесс исполнения. Concurrency — число заданий, которые один worker может обрабатывать параллельно. Эти параметры нельзя считать взаимозаменяемыми.
В синтетическом примере два workers имеют по два слота: W × C = 2 × 2 = 4 номинально одновременных задания. Если один worker остановлен, остаётся 1 × 2 = 2 слота. Это расчёт ёмкости, а не прогноз скорости.
Если позже измерена средняя длительность задания t секунд и других ограничений нет, выражение R ≈ W × C / t даёт только верхнюю оценку числа заданий в секунду. Реальный предел определит минимальная доступная ёмкость среди CPU, памяти, Postgres и внешнего API. Среднее также не заменяет p95: несколько долгих операций могут занять все слоты.
Нагрузочную проверку проводите проходами, меняя один параметр за раз. Для каждого прохода фиксируйте:
- W и C;
- входную λ и завершённую μ;
- p95 длительности;
- CPU и память каждого процесса;
- соединения и задержки Postgres;
- ошибки и ограничения внешнего API;
- глубину очереди Q и возраст старейшего задания A.
Увеличивать W или C имеет смысл, пока μ растёт без неприемлемого роста ошибок, p95, Q и A. Универсального числа workers нет. Больше concurrency может усилить конкуренцию за память, соединения базы и квоту API.
Отдельно проверьте четыре условия.
Webhook processors. Они нужны не всегда. Их применимость и маршрутизацию проверяют для текущей версии, размещения и ожидаемого потока webhook-запросов.
Binary data. Официальная документация не поддерживает обычный filesystem mode для binary data в queue mode. Поэтому локальный диск отдельного worker нельзя считать общим хранилищем. Для выбранной версии и редакции нужно согласовать поддерживаемый режим, доступный всем нужным компонентам.
Большие ответы. В queue mode ответ webhook возвращается от worker к принимающему процессу через очередь. Предел, потребление памяти Redis и возможность вынести тело ответа во внешнее хранилище зависят от версии и настроек. Например, документированная функция offload больших ответов доступна начиная с n8n 2.34.0; её нельзя переносить на более раннее развёртывание без обновления и проверки хранилища.
Multi-main. Несколько main-процессов повышают доступность принимающего и управляющего слоя, но не заменяют workers и не ускоряют исполнение заданий сами по себе. По актуальной документации n8n эта схема доступна в self-hosted Enterprise и недоступна в n8n Cloud. Все main и workers должны работать на одной версии; main — в queue mode, с общими Postgres и Redis. Перед main нужен балансировщик со sticky sessions. Один main становится leader и выполняет задачи, которые должны запускаться не более чем одним main, включая не-HTTP-триггеры и очистку данных; остальные работают как followers и обслуживают API, интерфейс и webhooks. При отказе leader его роль получает другой main. Это механизм высокой доступности, а не гарантия exactly-once для внешних действий. Для решения задачи из этой статьи сначала проверьте main, Redis, Postgres и workers; multi-main рассматривайте отдельно, если нужен отказоустойчивый управляющий слой.
Как пережить отказ worker и не потерять действие
Очередь не является гарантией exactly-once для внешней операции. Worker может отправить запрос во внешнюю систему, получить там успешную запись и остановиться до сохранения подтверждения. Повторное исполнение тогда способно снова отправить тот же запрос.
Защиту строят вокруг проверяемой идемпотентности:
- Назначьте каждому заданию стабильный идентификатор и передавайте его как idempotency key.
- Внешняя система выполняет
create-or-return-existingили upsert по этому ключу, если её API и правила данных это позволяют. - После тайм-аута сначала запросите результат по ключу.
- Повторяйте запись только когда проверка показала, что действие не завершено.
Если API внешней системы не поддерживает такой ключ, проекту нужен собственный реестр операций и согласованное правило поиска дубля. Возможность реализации проверяют по реальному API; название метода само по себе ничего не гарантирует.
Для восстановления также нужны одинаковые совместимые настройки, общий ключ шифрования и доступ нужных компонентов к Redis, Postgres и выбранному binary storage. Локальные файлы одного worker не должны быть единственным местом хранения данных, которые понадобятся другому worker после отказа.
Backpressure задают как правило эксплуатации. Владелец процесса определяет предупредительный возраст A_warn, стоп-возраст A_stop и допустимый предел Q по реальному времени ожидания. При A ≥ A_warn оператор проверяет CPU, память, Postgres, workers и внешний API. При A ≥ A_stop или достижении лимита Q система ограничивает либо останавливает приём по заранее утверждённой процедуре. Без SLA и профиля нагрузки численные пороги были бы выдумкой.
Учебный пример: путь от входных данных до результата
Ниже — синтетический сценарий по документированной архитектуре, а не клиентский кейс, бенчмарк или результат живого теста n8n.
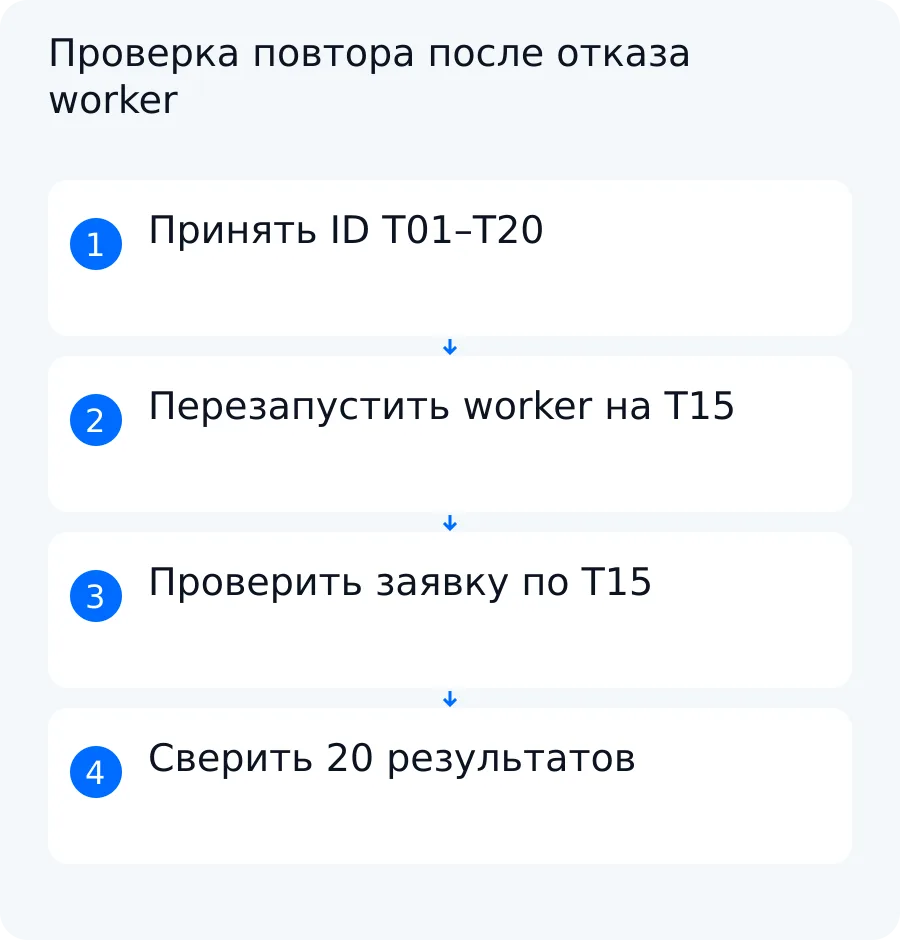
Исходные данные. В очередь поступают 20 независимых заданий с уникальными ID T01–T20. Работают условные worker A и worker B, у каждого concurrency равен 2. Номинальная параллельность — четыре задания. Внешняя операция создаёт заявку по idempotency key, равному ID задания.
Промежуточное решение. Worker B обрабатывает T15, создаёт внешнюю заявку и перезапускается до подтверждения результата в execution. T15 поступает на повторную попытку. Перед новой записью интеграция ищет результат по ключу T15; внешняя система возвращает уже созданную заявку.
Ожидаемая сверка. Уникальных принятых ID — 20. Попыток исполнения — 20 + 1 = 21. Уникальных завершённых ID — 20. accepted − completed = 0, поэтому пропавших ID нет; completed − accepted = 0, поэтому лишних ID нет. Повторных попыток — 21 − 20 = 1. Внешних заявок ожидается 20 только при фактически работающей идемпотентности по ключу.
| Компонент | Назначение | Общие настройки | Метрика | Поведение при отказе |
|---|---|---|---|---|
| Main | Принимает события и планирует executions | Общие ключ, Postgres и Redis | Принятые ID, ошибки создания execution | Не считается гарантией exactly-once; оператор проверяет приём и связь с очередью |
| Redis | Передаёт задания workers | Единые параметры подключения | Глубина Q, возраст A, ошибки соединения | Приём или выдача заданий нарушаются; мониторинг подаёт сигнал оператору |
| Postgres | Хранит состояние executions | Общая поддерживаемая конфигурация | Задержка, соединения, ошибки | Нагрузку не наращивают до восстановления и проверки состояния |
| Worker A | Выполняет независимые задания | Общие ключ, БД, Redis, binary storage; C = 2 | Активные задания, ошибки, длительность | Другой worker продолжает работу в пределах доступных слотов |
| Worker B | Выполняет независимые задания | Общие ключ, БД, Redis, binary storage; C = 2 | Активные задания, ошибки, длительность | После перезапуска результат незавершённого действия проверяют до повтора |
| Внешняя система | Создаёт заявку по idempotency key | Согласованное правило записи и поиска | Уникальные ключи, конфликты, ошибки API | Повтор T15 должен вернуть существующий результат, а не вторую заявку |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Вывод из примера ограничен правилами сценария: два workers сохраняют часть номинальной ёмкости после отказа одного процесса, но сами по себе не предотвращают повтор внешнего действия. От дубля защищает проверенная идемпотентная операция.
Как проверить результат перед запуском
Сначала сверьте проект с документацией именно установленной версии n8n. Зафиксируйте режим executions, общий ключ, подключения Redis и Postgres, параметры workers и способ хранения binary data. Не предлагайте обычный локальный filesystem mode для binary data в queue mode: документация указывает, что такая комбинация не поддерживается.
Затем проведите два сценария на синтетических данных. До проверки запишите ожидаемый результат, сигнал ошибки и действие человека.
| Сценарий | Ожидаемый результат | Сигнал ошибки | Действие человека |
|---|---|---|---|
Нормальный путь: T01–T20 | 20 уникальных принятых ID, 20 уникальных завершённых ID и 20 внешних заявок | Множества ID расходятся, есть ошибка исполнения или возраст очереди растёт | Остановить увеличение нагрузки; проверить логи, Redis, Postgres, workers и внешний API |
Исключение: worker перезапускается на T15 после записи | 21 попытка, 20 уникальных завершений и 20 заявок | Две заявки с ключом T15, пропавший T15 или зависшее задание | Приостановить поток, сверить внешний результат по ключу и только затем разрешить повтор |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Дополнительно проверьте готовность worker через документированные health endpoints и доступность метрик для выбранного размещения. Ответ /healthz говорит о достижимости процесса, но не подтверждает состояние подключений. Readiness endpoint worker проверяет соединения с базой данных и Redis. Health endpoints worker нужно включить настройкой; доступность метрик, экранов и отдельных функций зависит от self-hosted или Cloud, редакции и конфигурации.
Критерий приёмки — не отсутствие ошибок в одном показе, а воспроизводимая сверка входных и завершённых ID, внешних ключей и состояния очереди. Queue mode не следует описывать как гарантию exactly-once.
Что согласовать для внедрения
Готовый механизм n8n обеспечивает queue mode, workers, подключения к Redis и базе, параметры concurrency и средства наблюдения в пределах конкретной версии и редакции. Собственная интеграция определяет другое: какие задания независимы, какой ID станет ключом операции, как проверить внешний результат, когда повтор разрешён и при каком возрасте очереди остановить входящий поток.
Решение о queue mode принимают после замера узкого места. Следующий практический шаг — разобрать профиль нагрузки действующего n8n: λ, μ, p95, CPU, память, Postgres, внешний API, Q и A. Затем можно согласовать один нагрузочный сценарий и критерии отказа.
Switch On AI может помочь разобрать эту операцию и после проверки данных, API, версии, тарифа и прав разработать подходящий ИИ-помощник, бота или обычную интеграцию. Для самой задачи распределения executions чаще нужна интеграционная и эксплуатационная логика, а не ИИ-агент. Описание форматов работы находится на странице услуг.
Статья не подтверждает совместимость с конкретным экземпляром n8n и не доказывает выполненный проект у этого вендора. Срок, эффект и состав разработки нельзя определить без профиля нагрузки и проверки подключений. Прототип также не равен полноценному внедрению.
Чтобы начать предметно, выберите одну операцию: например, приём события, создание заявки по ключу и обработку повтора после отказа worker. Затем свяжитесь со Switch On AI, чтобы разобрать профиль нагрузки и согласовать прототип с ожидаемым результатом и условиями остановки.
Вопросы по этой задаче
Ускоряет ли queue mode один workflow?
Не обязательно. Queue mode распределяет независимые executions между workers и рассчитан на общую пропускную способность. Последовательные шаги одного workflow сохраняют свои зависимости, а передача через очередь может добавить задержку отдельному webhook-запросу.
Когда нужны дополнительные workers?
Когда нагрузочный сценарий показывает, что входная интенсивность выше завершённой, очередь растёт, а CPU, память, Postgres и внешний API ещё допускают дополнительную параллельность. Универсального числа workers нет: каждый следующий шаг проверяют по метрикам.
Что случится при падении worker?
Другие workers могут продолжить независимые задания в пределах оставшейся concurrency. Незавершённое задание может потребовать повтора, поэтому перед повторной внешней записью проверяют результат по idempotency key. Сама очередь не гарантирует exactly-once.