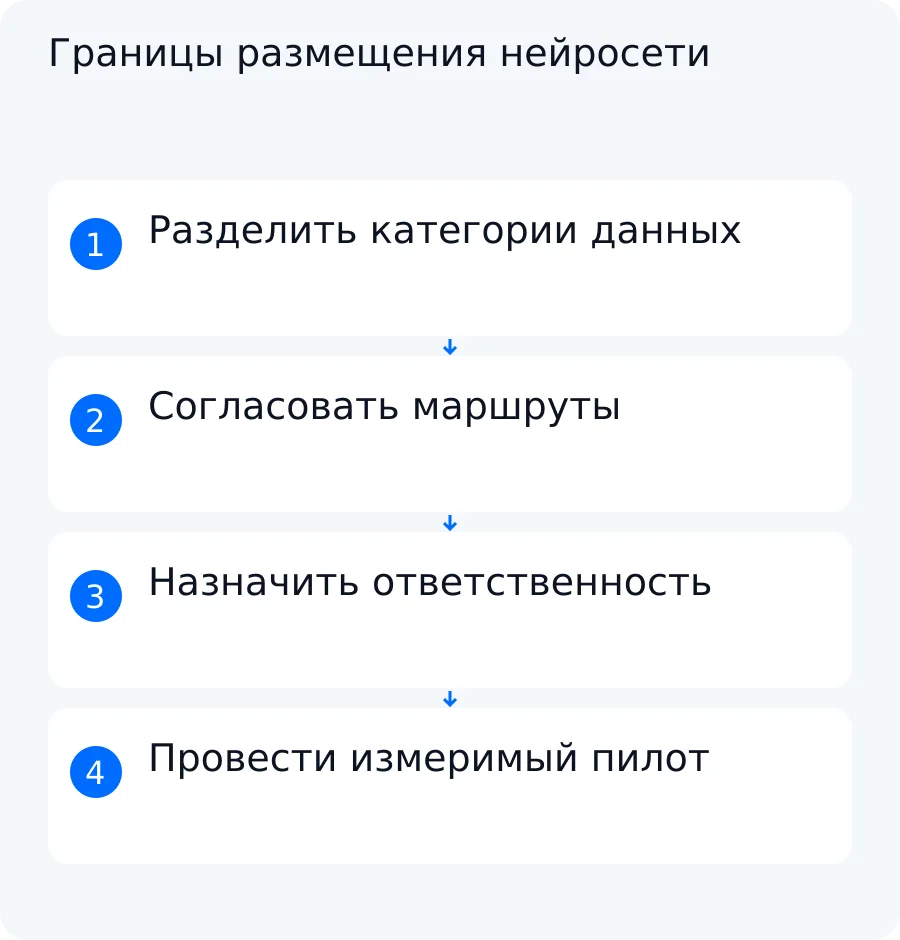
Локальная нейросеть для бизнеса — не обязательно полностью автономная система. Модель может выполнять вычисления на сервере компании, но обращаться к облачному поиску, внешней авторизации или другому API. И наоборот: при работе с облачной моделью можно оставить исходные документы внутри компании и передавать только разрешённые фрагменты.
Поэтому сначала определите границы данных и ответственность за эксплуатацию. Затем сравните варианты на одной операции и одинаковой нагрузке. Название продукта, наличие GPU или низкая цена одного запроса сами по себе не доказывают безопасность, скорость и экономию.
Что означает локальное и облачное размещение
Слово «локальная» описывает место выполнения модели, но не весь поток данных. Для выбора нужно раздельно описать четыре слоя:
- Вычисления. Где модель принимает запрос и формирует ответ: на сервере компании, у провайдера API или в обоих контурах.
- Хранение. Где лежат исходные документы, индексы, история запросов, журналы и резервные копии.
- Внешние инструменты. Обращается ли система к облачному поиску, авторизации, аналитике, хранилищу или другому API.
- Доступ пользователей. Через какой интерфейс сотрудники входят в систему, кто выдаёт роли и как закрывается доступ уволенному сотруднику.
Локальная модель на своём сервере не гарантирует полностью изолированный контур. Например, документация Ollama, проверенная 7 октября 2026 года, различает локальную работу и облачные модели, а также описывает отключение облачных функций. Значит, одного названия инструмента недостаточно: нужно проверить выбранный режим, конфигурацию и фактические сетевые маршруты.
Облачное размещение тоже не сводится к формуле «все данные уходят наружу». Локальный компонент может извлечь из документа только разрешённый фрагмент, удалить запрещённые поля и отправить подготовленный запрос через контролируемый шлюз. Но такой маршрут должен утвердить владелец данных.
Какие ограничения бизнеса описать сначала
Начните не с выбора модели, а с карточки данных и операции. Для каждой категории зафиксируйте:
- владельца, который разрешает использование данных;
- содержание и уровень доступа: общедоступные, внутренние или ограниченные сведения;
- разрешённых получателей и запрещённые направления передачи;
- допустимый маршрут от документа до ответа сотруднику;
- требования к задержке, часам доступности и работе при сбое;
- состав журналов и круг сотрудников, которые могут их читать;
- срок хранения исходных данных, запросов, ответов и резервных копий.
Например, внутренний регламент может быть доступен всем сотрудникам, но это не означает разрешения передавать его внешнему провайдеру. А общедоступный FAQ можно отправлять в согласованный API, хотя история обращений пользователей может содержать закрытые сведения.
Юридическую допустимость нельзя вывести из общей статьи. Уполномоченный специалист заказчика должен проверить конкретные данные, продукт, редакцию условий и договор. Его решение становится ограничением проекта: какие поля разрешено передавать, кому, для какой цели и на какой срок.
Что потребуется для локального варианта
Локальный вариант переносит вычисления в контролируемую среду, но одновременно передаёт компании больше эксплуатационных задач. Нужно выбрать конкретную модель и версию среды, проверить совместимость с операционной системой и оборудованием, определить требования к оперативной памяти и памяти GPU, оценить хранилище, обновления и резерв.
Характеристики нельзя угадывать по чужой конфигурации. Объём памяти зависит от выбранной модели, её варианта, размера контекста и параллельной нагрузки. Наличие подходящего GPU также проверяют по документации среды и на оборудовании заказчика. Чужой тест на Mac или видеокарте другой модели не подтверждает производительность вашей системы.
Учебная последовательность подготовки
Это обзор по документации, а не отчёт о выполненном запуске и не универсальный установочный скрипт:
- Выбрать модель, её вариант и версию среды. Сверить системные требования, лицензию и совместимость с CPU или GPU.
- Подготовить память, хранилище, журналирование и отдельное место для резервных копий. Зафиксировать, какие файлы и настройки нужно восстанавливать.
- Ограничить входящие и исходящие соединения. Разрешить только согласованные адреса и проверить, отключены ли ненужные облачные функции.
- Провести тест на обычной и пиковой нагрузке, затем восстановить конфигурацию и данные из резерва.
Документация Ollama описывает режимы загрузки в CPU, GPU либо оба типа памяти, сетевую привязку сервера и отдельное отключение облачных возможностей. Эти сведения относятся к документированным возможностям продукта на дату проверки, но не доказывают совместимость с оборудованием конкретной компании и не заменяют её тест.
Также заранее назначьте ответственных. Кто устанавливает обновления модели и среды? Кто проверяет их перед рабочим запуском? Кто следит за свободным местом, очередью запросов и журналами? Кто восстановит систему, если основной сервер недоступен? Один сервер без проверенного резерва и порядка восстановления остаётся единственной точкой отказа, а не готовым производственным контуром.
Что проверить в облачном API
Для облачного API проверяйте конкретный продукт, тариф и действующую редакцию условий. Правила потребительского чата нельзя автоматически переносить на коммерческий API.
Соберите ответы на следующие вопросы:
- в каких единицах считается использование и какие дополнительные функции оплачиваются отдельно;
- где обрабатываются и хранятся запросы и ответы;
- каков стандартный срок хранения и какие исключения действуют;
- используются ли данные для обучения и можно ли изменить это условие;
- как удаляются данные и что сохраняется в журналах;
- какие роли, ключи, лимиты и ограничения доступны;
- какие условия закреплены публичной документацией, а какие — договором.
Политика Anthropic, проверенная 7 октября 2026 года и датированная 1 июля 2026 года, отдельно описывает коммерческие продукты, включая Anthropic API, и потребительские планы. Для API в ней указан стандартный срок удаления входов и выходов с исключениями: отдельные сервисы с иным хранением, специальное соглашение, требования политики использования и закона. Этот пример показывает, почему фразу «данные не хранятся» нельзя применять без проверки продукта и исключений.
Стоимость сравнивают за один период и при одинаковой нагрузке. Для облака расчёт можно представить так:
число расчётных единиц входа × ставка входа + число расчётных единиц выхода × ставка выхода + дополнительные платные функции.
Размер расчётной единицы и состав тарифицируемых операций нужно взять из условий выбранного API: ставка может быть указана не за один токен.
Для локального варианта учитывают оборудование и подготовку, распределённые по выбранному сроку использования, электроэнергию, администрирование, обновления и резервное копирование. Численный итог появится только после выбора модели, API, тарифа, объёма токенов и периода. Подробный расчёт расходов относится к отдельной задаче, а здесь важно не сравнивать одну строку облачного счёта со всей стоимостью локальной эксплуатации.
Как сравнить эксплуатацию и гибридную схему
Сравнивайте не только место модели, но и владельцев решений. Матрица ниже задаёт вопросы для проекта; ответы нужно заполнить для выбранных продуктов и команды.
| Объект | Владелец решения | Локальная сторона | Провайдер API | Что покидает контур | Журналирование | Обновления | Резерв и восстановление | | --- | --- | --- | --- | --- | --- | --- | --- | --- | | Исходные документы | Владелец данных заказчика | Хранит и выдаёт доступ | Не получает без разрешения | Только разрешённый фрагмент либо ничего | Доступ и извлечение | Правила обработки | Копия и проверка восстановления у заказчика | | Модель | Владелец ИТ-сервиса | Выбирает версию и обслуживает локальный запуск | Обслуживает облачную модель по своим условиям | Запрос в согласованном составе | Версия и вызов модели | Локально — команда; в API — провайдер | Локально резервируют конфигурацию; API требует план замены или обхода | | Ключи и роли | Ответственный за доступ | Корпоративная авторизация и прокси | Проверяет ключ и разрешённые операции | Идентификаторы и метаданные по условиям продукта | Входы, отказы, смена ролей | Заказчик меняет роли и ключи | Процедура перевыпуска и аварийного отключения | | Ответ модели | Владелец процесса | Фильтрует, показывает сотруднику, хранит по правилам | Возвращает результат запроса | Зависит от последующих интеграций | Результат, ошибка и решение человека | Правила проверки ответа | Сохраняют только необходимое для работы и разбора |
В гибридной схеме поток может выглядеть так:
- Документ остаётся в локальном хранилище.
- Локальный компонент извлекает разрешённый фрагмент.
- Фильтр удаляет запрещённые поля и записывает решение в журнал.
- Разрешённый запрос уходит в API, а ответ возвращается через контролируемый шлюз.
Такая схема не становится безопасной автоматически. Нужно проверить качество фильтра, возможность восстановить исходные сведения из оставшегося контекста, содержание журналов и поведение при ошибке API.
Сотрудников подключают через корпоративную авторизацию, роли и прокси с согласованными правилами доступа. Не следует выставлять порт локальной модели напрямую в интернет только ради удалённой работы. Способ защиты, сертификаты, ограничения сети и журналирование определяет ответственная ИТ-команда.
Если сравниваете собственное размещение других компонентов автоматизации, полезен материал о n8n Cloud и собственном сервере. Принцип похож: место запуска меняет ответственность за обновления, резерв и восстановление, но не отвечает за все вопросы безопасности само по себе.
Учебный пример выбора для трёх категорий документов
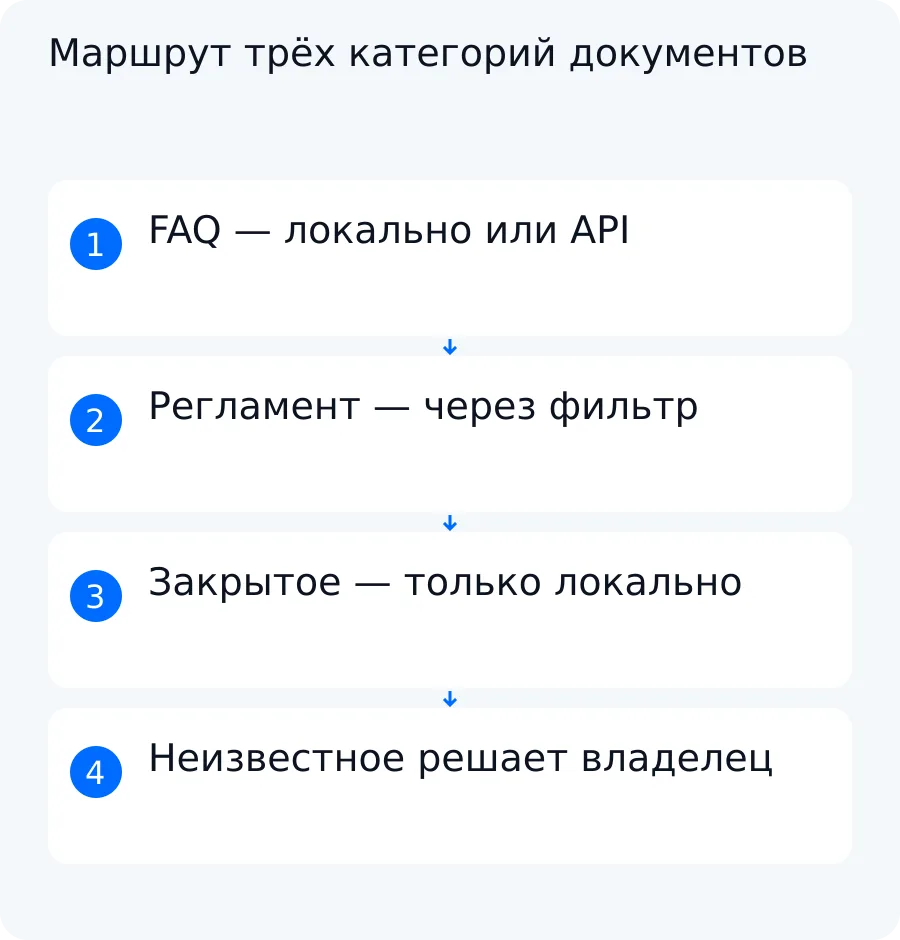
Ниже — синтетический пример, а не клиентский кейс и не результат внедрения Switch On AI. В условной выборке есть 60 документов: по 20 для общедоступного FAQ, внутреннего регламента и категории ограниченного доступа.
| Категория | Требование владельца | Допустимые сервисы | Поддержка | Предварительный выбор | Что неизвестно |
|---|---|---|---|---|---|
| Общедоступный FAQ, 20 документов | Разрешено использовать для ответов сотрудникам и посетителям | Локальная модель или согласованный облачный API | Внутренняя команда либо провайдер по договору | Оба варианта допустимы; сравнить качество, задержку и эксплуатацию | Какой API, тариф и режим хранения будут выбраны |
| Внутренний регламент, 20 документов | Наружу можно передавать только согласованные фрагменты после решения владельца | Локальный контур; облачный API — только для разрешённых фрагментов | Нужен владелец фильтра и ответственный за исключения | До решения владельца — локальная обработка; после разрешения можно проверить гибридную схему | Разрешена ли отправка фрагментов конкретному API и на каких договорных условиях |
| Документ ограниченного доступа, 20 документов | Внешняя передача запрещена до отдельного разрешения | Только контролируемый локальный контур | Внутренняя ИТ-команда и владелец доступа | Локальная обработка без внешнего маршрута | Совместимость модели, оборудования и требований к качеству |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Пока отправка фрагментов внутреннего регламента не разрешена, во внешний маршрут может попасть только категория FAQ: 20 / 60 × 100% = 33,3% документов синтетической выборки. Если владелец разрешит также регламенты, верхняя граница составит (20 + 20) / 60 × 100% = 66,7%. Документы ограниченного доступа не входят ни в один внешний маршрут.
Эти доли описывают только состав учебной выборки. Они ничего не говорят о числе запросов, трафике, стоимости, качестве ответов или результате клиента.
Для окончательного выбора не хватает одного решения: разрешает ли владелец отправлять фрагменты внутреннего регламента конкретному API и какие договорные условия должны выполняться. Пока ответа нет, нельзя объявить облачный или гибридный вариант допустимым для этой категории.
Локальная установка также не считается полностью автономной автоматически. Если в среде включены облачные модели, веб-поиск, внешняя авторизация или телеметрия, эти маршруты нужно отдельно разрешить либо отключить и проверить.
Как проверить решение до масштабирования
Пилот должен отвечать не на вопрос «работает ли нейросеть», а на вопрос «выполняет ли выбранная схема требования владельца на нашей нагрузке». До запуска запишите ожидаемый результат и условие остановки для каждой проверки.
| Проверка | Что сделать | Что зафиксировать |
|---|---|---|
| Сеть | Проверить разрешённые и запрещённые входящие и исходящие маршруты | Адрес, направление, основание доступа и результат блокировки |
| Журналирование | Выполнить обычный запрос, запрещённый запрос и смену роли | Какие события записаны, кто видит журнал и нет ли в нём лишних данных |
| Нагрузка | Подать обычную и расчётную пиковую нагрузку | p50 и p95 задержки, ошибки, очередь, CPU, GPU, память и пропускную способность |
| Отказ API | Отключить внешний сервис в тестовом контуре | Получил ли сотрудник понятную ошибку, сохранился ли запрос, исключена ли ложная отметка об успехе |
| Восстановление | Восстановить конфигурацию и нужные данные из резерва | Фактическое время, потерянные данные и расхождения с инструкцией |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Для учебного плана нагрузки возьмём 10 пользователей, по 6 запросов в час в течение 8 часов. Это 10 × 6 × 8 = 480 запросов за рабочий день и в среднем 480 / 8 = 60 запросов в час. При условном коэффициенте пика 3 точка нагрузочного теста составит 60 × 3 = 180 запросов в час, или 3 запроса в минуту.
Это расчётная точка будущего теста, а не измеренная производительность. Фактические p50 и p95 задержки, долю ошибок, загрузку CPU и GPU, расход памяти и стоимость заполняют только после теста выбранной конфигурации. Целевые RTO, RPO, допустимую задержку и долю ошибок утверждает владелец процесса.
Скорость и экономию также сравнивают по фактическим замерам одной операции. Если локальная модель отвечает быстро в одиночном диалоге, это ещё не подтверждает работу при параллельной нагрузке. Если облачный запрос стоит недорого, это не учитывает повторные обращения, подготовку данных, дополнительные функции и поддержку.
Switch On AI может разобрать одну операцию, зафиксировать требования владельца данных и согласовать измеримый прототип ИИ-помощника, бота или интеграции после проверки данных и API. Формат решения зависит от поведения системы: диалог сам по себе не делает её ИИ-агентом, а фиксированный маршрут может не требовать агента вообще. Подробнее — на странице разработки ИИ-агентов.
Следующий шаг — описать операцию и ограничения: какие документы участвуют, кому принадлежит решение о передаче, какая нагрузка ожидается и кто отвечает за обновления и восстановление. После этого можно сравнить варианты на одинаковых условиях и согласовать прототип без обещания заранее заданной скорости, экономии или полного отраслевого внедрения.
Вопросы по этой задаче
Локальная модель всегда работает без интернета?
Нет. Вычисления могут выполняться локально, но среда может обращаться к облачным моделям, поиску, авторизации, обновлениям или другим API. Для автономного режима нужно проверить конфигурацию и сетевые маршруты, отключить ненужные облачные функции и испытать работу при заблокированном внешнем доступе.
Можно ли отправлять внутренние документы в облако?
Только после решения владельца данных и проверки конкретного API, условий продукта и договора. Иногда допустимо оставить документ локально и передать разрешённый фрагмент, но состав фрагмента, фильтрацию, хранение и журналирование нужно согласовать отдельно. Общая статья не заменяет юридическую и отраслевую проверку заказчика.
Кто обновляет модель и сервер?
В локальном варианте ответственных назначает компания: кто проверяет и устанавливает обновления, наблюдает за ресурсами, делает резервные копии и восстанавливает систему. В облачном API модель обслуживает провайдер, но заказчик всё равно управляет ключами, ролями, интеграцией, журналами и планом работы при недоступности сервиса.