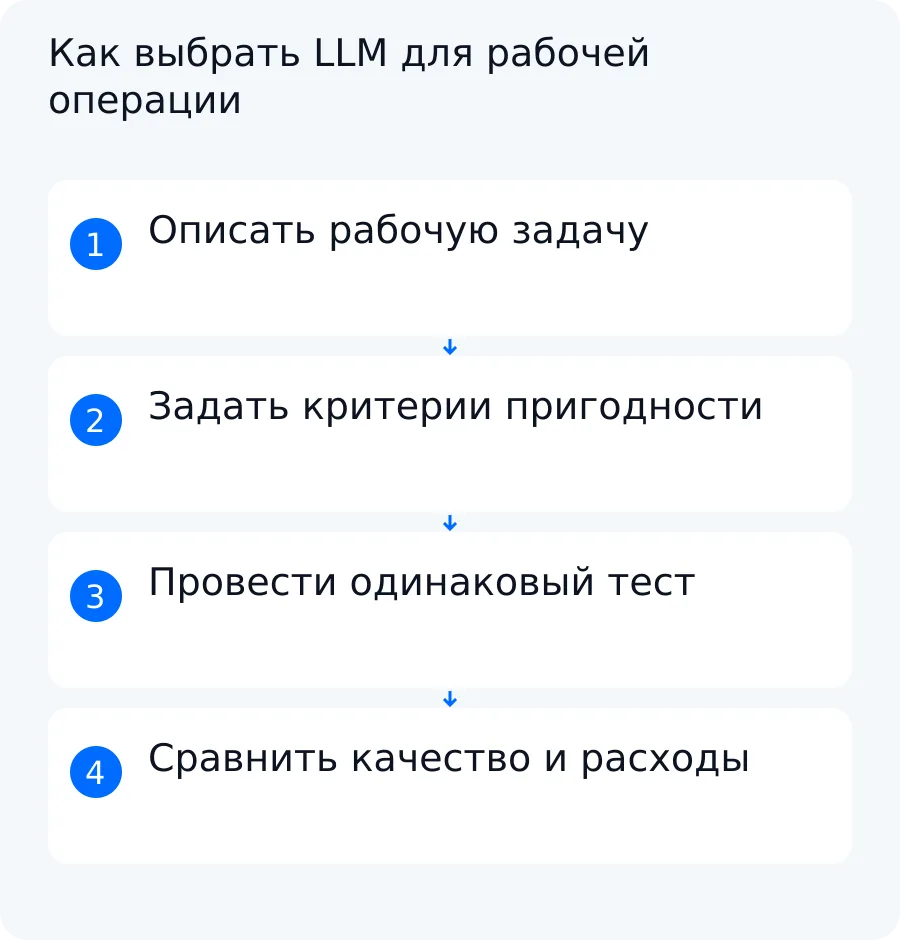
Выбор LLM начинается не с таблицы лидеров, а с описания результата, который нужен в конкретной операции. Сначала определите обязательные поля, допустимые ошибки и правила остановки. Затем дайте моделям одинаковые задания в одинаковых условиях и сравните не только средний балл, но и критические ошибки, задержку и стоимость пригодного ответа.
Такой тест не доказывает, какая модель лучше вообще. Он помогает решить более узкий и полезный вопрос: какой вариант можно допустить к вашей операции при заданных ограничениях.
Почему модель выбирают под рабочую задачу
В проекте легко смешать три разных решения: выбор базовой модели, архитектуру системы и место размещения. Их нужно оценивать отдельно.
Базовая LLM преобразует полученный контекст в ответ: извлекает поля, классифицирует обращение, готовит черновик или выбирает предложенное действие. Её проверяют на конкретных входах и ожидаемых результатах.
Архитектура агента определяет, какие данные и инструменты доступны модели, как система хранит состояние, проверяет ответ и передаёт исключение человеку. Слабый поиск по документам или неверная маршрутизация могут испортить результат независимо от качества базовой модели. И наоборот, ограничения и детерминированная валидация могут остановить опасный ответ до следующего шага.
Размещение влияет на доступ к данным, права, эксплуатацию и допустимые способы подключения. Это критерий допуска, а не характеристика интеллекта модели. Конкретный вариант размещения, лицензию, доступность API и права нужно проверять для выбранного продукта и условий заказчика.
Поэтому лидер общего рейтинга не обязательно решит рабочую задачу лучше остальных. Публичный рейтинг может измерять программирование, рассуждение или ответы на общие вопросы, а процессу требуется, например, извлечь пять реквизитов и не заполнять пропуски догадкой. Даже близкие задания могут по-разному оценивать ошибку: красивый, но недостоверный ответ иногда хуже явного отказа.
Граница этой статьи — сравнение базовых моделей на одном наборе заданий. Устройство системы из нескольких агентов, распределение ролей и маршрутизация между ними относятся к отдельному архитектурному решению.
Как задать критерии успешного результата
До первого запуска опишите, что считается пригодным ответом. Иначе команда посмотрит на результаты после эксперимента и невольно выберет признаки, выгодные понравившейся модели.
Для извлечения данных критерии можно записать так:
- ответ соответствует согласованной структуре;
- все обязательные ключи присутствуют;
- значения перенесены из разрешённого входа без догадок;
- отсутствующее значение обозначено
null, а не правдоподобной подстановкой; - противоречие отмечено отдельным признаком;
- система не выбирает один из конфликтующих вариантов без утверждённого правила;
- случай, требующий решения специалиста, передаётся человеку.
Тогда пригодность выражается простой логикой:
пригодный результат = формат соблюдён AND обязательные поля корректны AND нет выдуманных значений AND противоречия отмечены
Определите критические ошибки отдельно от обычных. Опечатка в необязательном комментарии и выдуманный ИНН не должны давать одинаковый штраф. Для операции с реквизитами критической ошибкой может быть любое выдуманное обязательное поле. При таком правиле одна галлюцинация способна остановить допуск модели, даже если средний балл выглядит высоким.
Полезно оформить паспорт проверки:
| Что фиксируем | Пример правила |
|---|---|
| Формат | Объект с утверждёнными ключами и типами |
| Обязательные поля | Номер заявки, организация, ИНН, сумма |
| Пропуск | null и признак missing_required_field |
| Противоречие | null, признак conflict и исходные варианты |
| Критическая ошибка | Модель придумала обязательное значение |
| Допустимая передача человеку | Отказ при нехватке данных или неразрешимом конфликте |
| Качество текста | Оценивается только после проверки фактов и структуры |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Критерии должны быть конкретными, измеримыми и связанными с назначением операции. Такой подход соответствует предоставленной официальной документации Anthropic по разработке тестов: она предлагает сначала определить критерии успеха, учитывать крайние случаи и сочетать количественные метрики с последовательной качественной оценкой. Численные пороги из чужих примеров переносить нельзя — их задаёт владелец процесса.
Задержку и стоимость оценивайте вместе с пригодностью. Быстрый ответ бесполезен, если сотруднику приходится заново проверять каждое поле. Низкая цена попытки тоже ничего не говорит без доли результатов, которые можно передать дальше по процессу.
Как собрать эталонные задания
Тестовая выборка должна напоминать реальную работу, но для первой безопасной проверки можно использовать обезличенные или синтетические входы. Включите не только обычные случаи, но и ситуации, в которых система обязана остановиться.
Для учебного теста возьмём пять полностью вымышленных заявок:
- Полная заявка с одним значением каждого реквизита.
- Полная заявка с другим порядком полей.
- Полная заявка с дополнительным необязательным комментарием.
- Неполная заявка без обязательного ИНН.
- Заявка с двумя противоречащими значениями суммы.
Для каждого входа профильный специалист заказчика готовит эталон. Он определяет не только правильные значения, но и ожидаемое поведение при нехватке данных. В заявке № 4 эталон может требовать inn=null и missing_required_field=true. В заявке № 5 — amount=null, conflict=true и сохранение обоих исходных значений для проверки человеком.
Эталон не должна придумывать команда тестирования без владельца процесса. Правила бухгалтерского, юридического, кадрового или отраслевого учёта задаёт и проверяет специалист заказчика. Модель оценивают по этим правилам, а не используют как источник самих правил.
Разделите материал как минимум на две части:
- настроечная часть помогает уточнить промпт, схему ответа и обработку ошибок;
- проверочная часть остаётся закрытой до итогового сравнения.
Если многократно исправлять промпт по всем пяти заданиям, они перестанут показывать переносимость решения на новые входы. Для небольшого учебного примера это ограничение нужно честно обозначить; в рабочем проекте выборку расширяют примерами из допустимого диапазона операции.
Не удаляйте неудобный пример после получения плохого результата. Зафиксируйте причину расхождения: неверный эталон, неоднозначный вход, недостаток инструкции или ошибка модели. Если даже специалисты не могут согласовать единственный ответ, задание следует пометить как неоднозначное и оценивать правило эскалации, а не угадывание.
Как провести сопоставимый эксперимент
Все модели должны получить одинаковый вход и одинаковые разрешённые условия. Для каждой попытки сохраните:
- идентификатор и заявленную версию модели;
- дату проверки;
- точный текст системной и пользовательской инструкции;
- исходное задание;
- схему ожидаемого ответа;
- доступные инструменты и источники контекста;
- параметры генерации и лимиты;
- способ доступа;
- фактический ответ без ручного исправления;
- начало и конец выбранного интервала измерения;
- результат автоматической и экспертной проверки.
Нельзя одной модели дать исправленный промпт, а результат другой оставить от ранней версии эксперимента. Если инструкция изменилась, повторите сравнение для всех кандидатов и сохраните новую серию отдельно.
Сначала задайте условия допуска
До содержательного теста проверьте, разрешён ли сам вариант для проекта. Сравнивать можно разные классы моделей, но не превращать это в неподтверждённый рейтинг:
| Критерий допуска | Что выяснить |
|---|---|
| Рабочая задача | Поддерживает ли выбранный способ доступа нужный формат взаимодействия |
| Контекст | Помещаются ли инструкции и входные данные в доступные ограничения |
| Способ доступа | API, управляемый сервис или другой согласованный вариант |
| Лицензия и права | Разрешено ли предполагаемое использование в условиях заказчика |
| Размещение | Соответствует ли вариант требованиям к данным и эксплуатации |
| Инструменты | Можно ли предоставить только необходимые действия и проверить их результат |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Это вопросы для проверки перед внедрением, а не утверждение о совместимости конкретных продуктов. Ссылку на отдельный материал о размещении стоит добавлять только после его публикации и приёмки.
Проверьте повторяемость отдельно
Первый проход по пяти заданиям показывает основной сопоставимый результат. Неоднозначные и рискованные примеры затем повторяют одинаковое число раз для каждой модели. Например, заявки № 4 и № 5 можно выполнить ещё по три раза.
Эти дополнительные попытки не следует незаметно включать в знаменатель основного показателя «4 из 5». Храните два результата:
- качество первых ответов на пяти одинаковых заявках;
- устойчивость решений на дополнительных повторах сложных заявок.
Для повторов можно считать долю одинаковых решений: сколько раз модель корректно обозначила пропуск или конфликт. Сохраняйте и сами ответы — один итоговый процент не объяснит, почему произошла ошибка.
Если весь автоматизируемый сценарий строится в n8n, проверку маршрутов, повторов и сбоев продолжает отдельный материал о тестировании AI-workflow в n8n. Здесь предмет уже: какую базовую модель допустить к одинаковой операции.
Как оценить ошибки, задержку и расходы
Часть результата можно проверять детерминированно. Для структурированного ответа валидатор проверяет схему, наличие ключей, типы, допустимые значения null и совпадение извлечённых данных с эталоном. Такой тест даёт воспроизводимый ответ: условие выполнено или нет.
Экспертная рубрика нужна там, где простого совпадения недостаточно. Специалист оценивает, правильно ли модель истолковала пропуск, сохранила ли смысл неоднозначного текста и верно ли передала конфликт человеку. Шкалу и примеры для каждого балла задают до запуска.
Автоматический судья на базе другой модели можно использовать как вспомогательный сигнал для большого массива ответов. Он не заменяет эталон и специалиста. Возьмите часть результатов, сравните оценки автоматического судьи с человеческими и вручную разберите расхождения. Если судья систематически ставит подробный стиль выше фактической точности, его балл нельзя использовать как решающий.
Не прячьте критическую ошибку в среднем
Отчёт должен показывать отдельно:
- число пригодных ответов;
- число критических ошибок каждого типа;
- число явных отказов и передач человеку;
- ошибки формата;
- результат экспертной рубрики;
- устойчивость на повторах.
Среднее полезно для обзора, но не отменяет стоп-критерий. Если допуск к выдуманным обязательным полям равен нулю, модель с одной такой ошибкой не проходит независимо от приятного стиля.
Измеряйте задержку на одной границе
Заранее решите, от какого до какого события идёт измерение: например, от отправки запроса до получения полного ответа приложением. Используйте одну границу для всех вариантов.
Для пяти первых попыток можно взять медиану. После сортировки значений t1 ≤ t2 ≤ t3 ≤ t4 ≤ t5 медиана равна t3. Это защищает основной показатель от одной случайно долгой попытки, но исходные значения всё равно нужно сохранить. В учебной статье нет измеренных миллисекунд: реальные числа появляются только после запуска в согласованных условиях.
Считайте стоимость пригодного результата
Учитывайте все фактически оплачиваемые попытки, в том числе повторы. Если применялся кэш, фиксируйте, на каких запросах и как он повлиял на расход. Общая формула:
C_total = Σ C_attempt
стоимость одного пригодного результата = C_total / N_usable
Если четыре из пяти ответов пригодны, знаменатель равен четырём. Для условных моделей получатся выражения C_A / 4 и C_B / 4; подставлять вымышленные тарифы не нужно. Полную тарифную таблицу и эксплуатационный бюджет здесь дублировать не следует: состав расходов зависит от выбранных сервисов, нагрузки и размещения.
Учебный пример сравнения на неполной заявке
Ниже — синтетический учебный пример. Это не бенчмарк названных продуктов, не собственный запуск реальных моделей и не результат клиента Switch On AI.
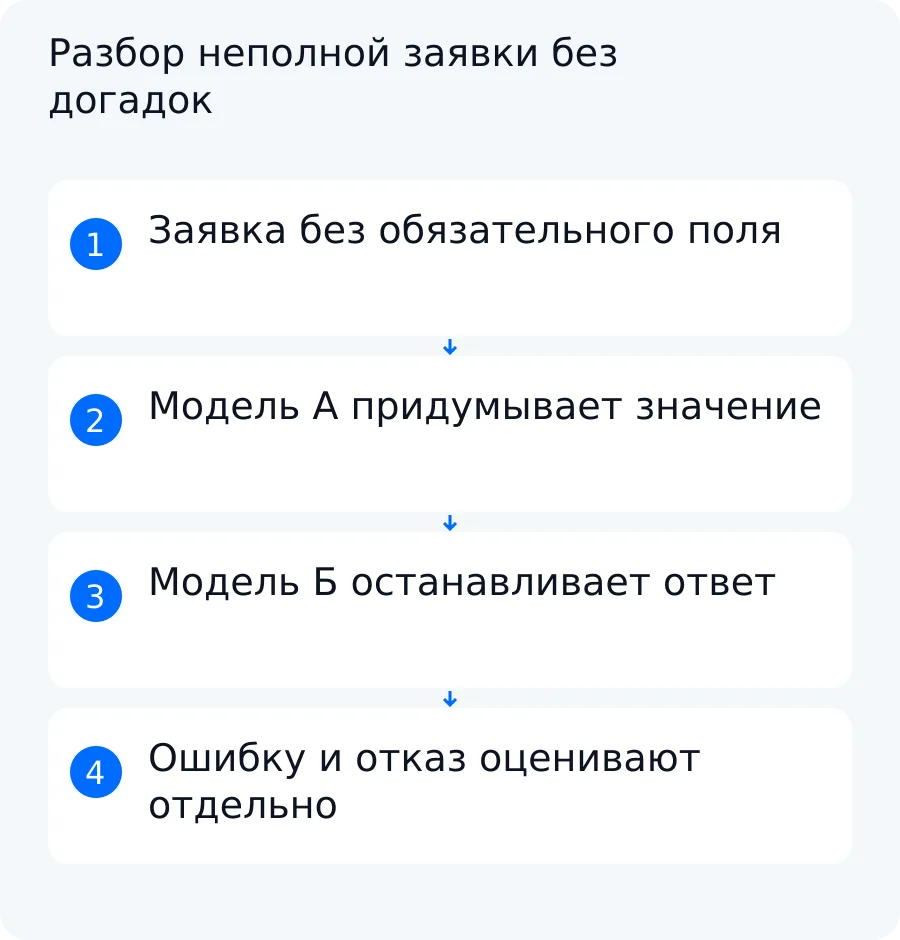
Пять условных заявок поступают на извлечение реквизитов. Три заявки полные, в четвёртой отсутствует ИНН, в пятой указаны две разные суммы. Эталон требует не заполнять отсутствующее значение и не выбирать сумму при конфликте.
Модель А правильно обрабатывает четыре заявки, но в неполной заявке придумывает ИНН. Модель Б также даёт четыре пригодных ответа, а на неполной заявке отказывается продолжать и передаёт её человеку.
| Задача | Эталон | Ответ модели | Ошибка | Стоимость | Решение |
|---|---|---|---|---|---|
| Модель А: пять заявок | 5 ответов без выдуманных полей; пропуски и конфликт отмечены | 4 пригодных; в одной заявке придуман ИНН | 1 критическая ошибка, 0 отказов | C_A / 4 за пригодный результат | Не допускать при нулевом пороге для выдуманных обязательных полей |
| Модель Б: пять заявок | 5 ответов без выдуманных полей; допустима передача исключения человеку | 4 пригодных; одна неполная заявка остановлена | 0 критических ошибок, 1 отказ | C_B / 4 за пригодный результат | Допустить по критической ошибке, если отказ действительно маршрутизируется человеку |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Сводные показатели воспроизводятся из пяти первых ответов:
| Показатель | Модель А | Модель Б |
|---|---|---|
| Пригодные ответы | 4 | 4 |
| Критические выдуманные поля | 1 | 0 |
| Отказы | 0 | 1 |
| Доля пригодных | 80% | 80% |
| Решение по критерию допуска | Не проходит | Проходит по критической ошибке при безопасной обработке отказа |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Расчёт доли пригодных одинаков: 4 / 5 × 100% = 80%. Критические ошибки модели А: 1 / 5 × 100% = 20%; у модели Б — 0%. Отказы модели А — 0%, модели Б: 1 / 5 × 100% = 20%.
Одинаковые 80% не делают модели равноценными. Отказ заметен: его можно направить сотруднику и сохранить исходную заявку. Выдуманный ИНН выглядит как заполненное поле и может пройти дальше как ложный факт. Поэтому критическая ошибка важнее приятного текста и общего среднего.
Это не означает, что любой отказ безопасен. До допуска нужно проверить маршрут: заявка не теряется, сотрудник видит причину остановки, а система не сообщает об успешной обработке. На повторах заявок № 4 и № 5 также проверяют, сохраняется ли такое поведение.
Как выбрать модель и контролировать изменения
Сформулируйте правило решения до просмотра финальной таблицы. Например, модель допускается, если одновременно выполнены условия:
- критических выдуманных обязательных полей — ноль;
- доля пригодных ответов не ниже порога, согласованного владельцем процесса;
- исключения корректно передаются человеку;
- задержка укладывается в лимит операции;
- стоимость одного пригодного результата укладывается в бюджет;
- права, способ доступа и размещение подходят для предполагаемого использования.
Порог качества, задержки и расходов нельзя взять из универсального рейтинга. Его определяют последствия ошибки и устройство конкретной операции. Для черновика внутренней заметки допустимые условия одни; для переноса обязательных реквизитов — другие.
Переход на другую модель разрешайте только после повторного теста на той же закрытой выборке и в сопоставимых условиях. Так команда увидит, улучшился ли нужный процесс, а не только название модели.
Повторная валидация нужна при изменении:
- версии или поставщика модели;
- промпта и схемы ответа;
- набора инструментов и доступного контекста;
- способа доступа или размещения;
- структуры входных данных;
- правил процесса и критериев приёмки.
Храните журнал серий: что изменилось, кто утвердил эталон, какие задания повторили и почему принято решение. Старые результаты не следует автоматически переносить на новую версию или другую операцию.
Switch On AI может помочь разобрать одну операцию, собрать обезличенные рабочие примеры и согласовать критерии прототипа. В зависимости от поведения решения это может быть ИИ-помощник, бот или обычная интеграция — термины не взаимозаменяемы. До разработки нужно отдельно проверить данные, доступные API, права и ограничения выбранных сервисов; статья не подтверждает совместимость с конкретным продуктом.
Описание подхода к ИИ-помощникам и границам их действий есть на странице разработки ИИ-агентов. Чтобы обсудить задачу, опишите одну операцию: вход, ожидаемый результат, сложный пример и ошибку, которую нельзя пропустить. Следующий разумный шаг — согласовать небольшой прототип и проверить его на утверждённой выборке, а не обещать эффект до испытания.
Вопросы по этой задаче
Достаточно ли публичного рейтинга моделей?
Нет. Рейтинг измеряет заданный авторами набор способностей, который может не совпадать с вашей операцией и ценой ошибки. Кандидатов нужно сравнить на одинаковых рабочих заданиях, заранее задав формат, критические ошибки, задержку и способ расчёта расходов.
Как сравнить отказ и ошибочный ответ?
Учитывайте их раздельно. Отказ может быть допустим, если он заметен и заявка передаётся человеку. Выдуманное обязательное поле опаснее: оно выглядит достоверным и может попасть в следующий этап процесса. Критическую ошибку нельзя скрывать общим средним баллом.
Когда нужно повторять тест?
После смены версии модели, промпта, инструментов, схемы ответа, входных данных, способа доступа или бизнес-правил. Переход на другую модель также проверяют на той же закрытой выборке и в сопоставимых условиях.