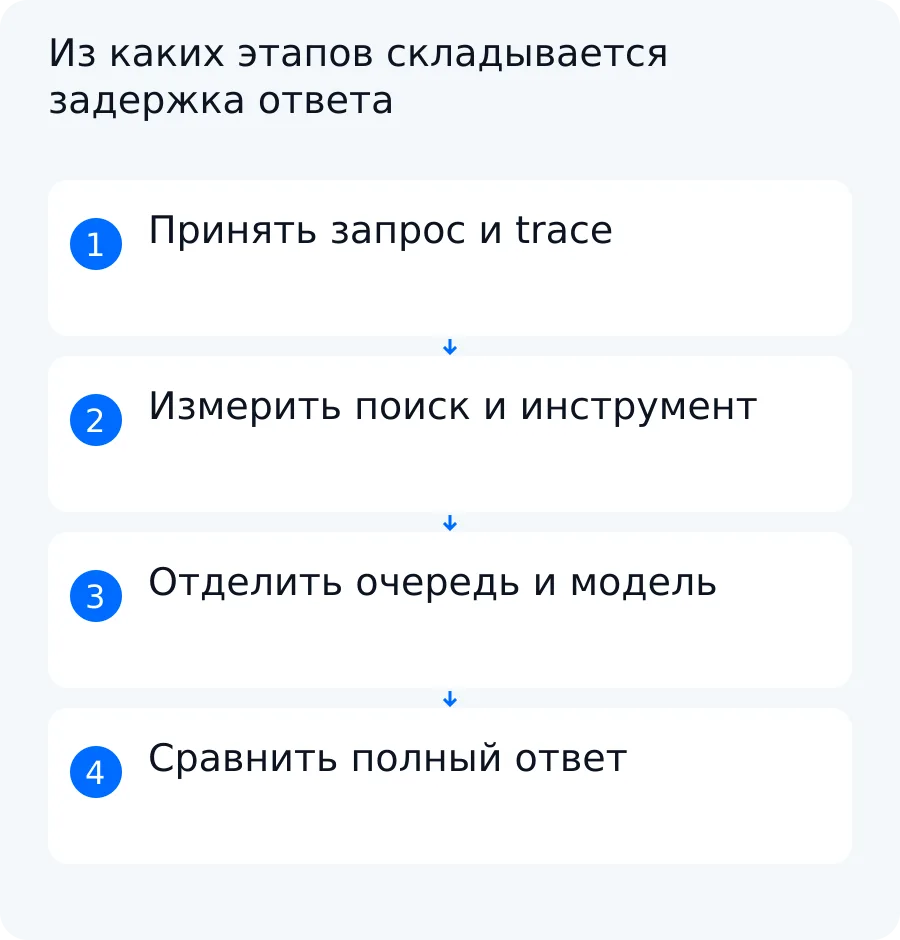
Владелец действующего ИИ-помощника видит проблему: пользователь отправляет запрос и ждёт пять секунд, но из общего времени непонятно, что именно тормозит. Причиной может быть поиск по базе знаний, внешний инструмент, очередь, сеть или генерация ответа моделью. Замена модели наугад в такой ситуации может ничего не изменить.
Чтобы найти узкое место, соберите временные отметки одной операции в общий trace, а затем повторите одинаковые запросы до и после одного изменения. Отдельно считайте время до первого токена, время до последнего токена и длительность каждого этапа. Так решение об ускорении опирается на измерение, а не на ощущение.
Какую задачу решает этот процесс
Процесс отвечает на конкретный вопрос: где ИИ-помощник тратит время от приёма запроса до готового ответа. На выходе владелец получает раздельные интервалы для retrieval, внешних инструментов, модели, очереди и сети. Если телеметрии для отдельного интервала нет, его нужно отметить как неизвестный, а не приписывать модели.
Здесь рассматриваются четыре прикладных рычага: размер передаваемого контекста, выбор модели, streaming и кэш. Руководство не заменяет общий мониторинг ИИ-агента и не рассчитывает месячный бюджет эксплуатации.
Ускорение LLM начинается не с перечня технологий, а с границ измерения. Один запрос должен иметь общий идентификатор, единые часы и понятные начало и конец каждого этапа. Иначе сумма локальных таймеров не объяснит время, которое увидел пользователь.
Какие данные и правила подготовить
Сначала зафиксируйте словарь полей. Для каждого поля укажите источник и человека, который отвечает за корректность записи.
| Статус | Поле | Источник | Ответственный | Что фиксировать |
|---|---|---|---|---|
| Обязательно | request_id или trace_id | журнал приложения | разработчик интеграции | единый идентификатор всей операции |
| Обязательно | время приёма | сервер приложения | разработчик приложения | момент получения запроса |
| Обязательно | начало и конец retrieval | трассировка поиска | владелец поиска | время получения контекста |
| Обязательно | начало и конец вызова модели | трассировка приложения или ответ API | разработчик приложения | полная длительность обращения к модели и статус |
| Обязательно | первый и последний токен | поток событий модели | разработчик приложения | начало выдачи и завершение ответа |
| Обязательно | начало и конец инструмента | трассировка вызова | владелец интеграции | длительность и статус операции |
| Обязательно | входные и выходные токены | ответ API или телеметрия провайдера | разработчик приложения | объём контекста и генерации |
| Обязательно | идентификатор сценария | контрольный набор запросов | владелец продукта | какой одинаковый сценарий выполнялся |
| Условно | ожидание в очереди | телеметрия очереди | владелец инфраструктуры | постановка и начало обработки |
| Условно | сетевой обмен | клиентские и серверные отметки | владелец инфраструктуры | отправка, получение и сетевые ошибки |
| Неизвестно | внутренние стадии инференса | данные провайдера, если доступны | владелец платформы модели | только раскрытые провайдером интервалы |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Обязательное поле нужно для базового сравнения. Условное записывают, если система действительно даёт такую телеметрию. Неизвестное оставляют неизвестным: по внешнему API обычно нельзя восстановить внутреннюю реализацию сервера только по времени ответа.
Короткий синтетический образец, не связанный с клиентскими данными:
| Поле | Условное значение |
|---|---|
trace_id | demo-trace-017 |
| сценарий | demo-policy-question |
| приём | 0,0 с |
| конец поиска | 0,4 с |
| конец инструмента | 1,5 с |
| конец прочего участка | 2,0 с |
| начало вызова модели | 2,0 с |
| первый токен | 2,3 с |
| последний токен и конец вызова модели | 5,0 с |
| токены | 1 200 входных, 180 выходных |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Имена, отметки и число токенов в образце условны. Это не файл клиента и не результат измерения Switch On AI.
До серии замеров согласуйте ещё четыре правила: одинаковый набор запросов, одинаковые критерии качества, сопоставимые условия нагрузки и единицы времени. Синхронизируйте часы сервисов либо измеряйте длительности монотонным таймером внутри одного компонента.
Как измерить задержку по этапам
Сначала укажите границы каждого показателя:
- прикладной TTFT = время первого токена − время приёма запроса приложением;
- модельный TTFT = время первого токена − время начала вызова модели;
- полное время = время последнего токена − время приёма запроса приложением;
- длительность этапа = время конца этапа − время его начала.
Прикладной TTFT показывает, когда пользователь начал получать ответ с учётом поиска, инструментов и других этапов до модели. Модельный TTFT относится только к вызову модели. Полное время показывает, когда ответ завершился. Субъективная отзывчивость шире обоих показателей: на неё влияют паузы между токенами, поведение интерфейса, индикатор работы и момент появления полезной части ответа.
Для условной трассы из предыдущего раздела прикладной TTFT равен 2,3 − 0,0 = 2,3 с, модельный TTFT — 2,3 − 2,0 = 0,3 с, а полное время — 5,0 − 0,0 = 5,0 с. После первого токена генерация продолжается ещё 5,0 − 2,3 = 2,7 с. Эти значения нельзя смешивать с длительностью модельного этапа: в учебном примере она составляет 3,0 с и включает работу модели до первого токена и после него.
Один запрос показывает устройство trace, но не обычное поведение системы. Для сравнения серий используйте медиану и p95. Медиана описывает середину выборки, а p95 помогает увидеть медленный хвост. Сравнение имеет смысл только для одного набора сценариев при одинаковых правилах запуска. Не объединяйте короткие справочные ответы и длинные аналитические ответы в одну цифру без разбиения по сценариям.
Отделите очередь и сеть от модели
Запишите ожидание до отправки запроса, сетевой обмен и обработку моделью отдельными интервалами, если телеметрия это позволяет. Рост времени до отправки указывает на очередь приложения. Рост сетевого интервала требует проверки соединения и промежуточных сервисов. Только оставшийся интервал можно обоснованно связывать с вызовом модели.
Параллельные участки нельзя просто складывать. Если поиск и независимый вызов инструмента начались одновременно, полное время определяется их временными границами, а не арифметической суммой длительностей. Расхождение между суммой этапов и общей длительностью — повод проверить перекрытия, пропуски и разные единицы времени.
Не смешивайте приложение и сервер инференса
Batching, quantization, speculative decoding и реализация attention относятся к возможным решениям владельца сервера модели. Их доступность зависит от выбранной инфраструктуры и провайдера. По внешнему API нельзя обещать такие изменения или представлять их как отдельную услугу обучения модели.
На стороне приложения обычно доступны другие действия: сократить лишний ввод, уменьшить ненужную генерацию, выбрать подходящую модель, убрать лишние последовательные запросы и распараллелить независимые операции. Официальное руководство OpenAI по latency описывает эти подходы как общие принципы, а не как гарантию одинакового результата для любой системы.
Какие изменения проверить первыми
Проверяйте по одному изменению за итерацию. Иначе trace покажет общий сдвиг, но не объяснит его причину.
- Уберите ненужный контекст. Проверьте повторяющиеся инструкции, дубли документов, лишнюю историю диалога и фрагменты, которые не нужны для ответа. Не удаляйте контекст только ради числа токенов: сначала отметьте обязательные факты.
- Сравните модели на конкретной задаче. Маленькая модель часто рассматривается как кандидат на быстрый маршрут, но её скорость и качество нужно измерить на вашей выборке. Название или размер сами по себе не подтверждают выигрыш.
- Добавьте кэш только для допустимых ответов. Определите ключ, срок актуальности, права доступа и условия сброса. Не кэшируйте результат, если он зависит от свежих данных или полномочий пользователя, которые не входят в ключ.
- Запускайте независимые операции параллельно. Поиск двух независимых источников можно начать одновременно. Вызовы с зависимостью сохраняют порядок: второй шаг нельзя запускать, пока не получен результат первого.
После каждого изменения повторите одинаковый набор запросов. Сравните TTFT, полное время, медиану, p95, ответы, ошибки и стоимость запроса. До такого сравнения изменение остаётся гипотезой, а не подтверждённым ускорением.
Как сохранить качество при ускорении
Streaming может быстрее показать первый фрагмент и улучшить воспринимаемую отзывчивость. При этом он не обязан уменьшать время до последнего токена. Поэтому после включения потока отдельно сравните TTFT, паузы между токенами и полное время.
Для кэша задайте пять правил:
- какие входные данные образуют ключ;
- как учитываются пользователь и его права;
- сколько результат считается актуальным;
- какое событие инвалидирует запись;
- что произойдёт при промахе или недоступности хранилища.
Результат одного пользователя нельзя выдавать другому только потому, что тексты запросов совпали. Если ответ опирается на изменяемый документ или состояние внешней системы, кэш должен учитывать версию данных либо сбрасываться после изменения.
Фразу «качество не изменилось» замените проверяемыми критериями. Для каждого сценария сравните:
- наличие обязательных фактов;
- число фактических ошибок;
- соблюдение требуемого формата;
- ошибки и тайм-ауты инструментов;
- корректность источников и полномочий;
- стоимость запроса по фактической телеметрии.
Владелец продукта заранее задаёт ожидаемый ответ или проверяемые признаки. Специалист заказчика проверяет бухгалтерские, юридические, кадровые и отраслевые правила, если они затронуты сценарием.
Учебный пример: путь от входных данных до результата
Ниже — полностью синтетическая трасса. Все имена и числа учебные: они показывают расчёт и не являются клиентским кейсом, живым тестом или результатом Switch On AI.
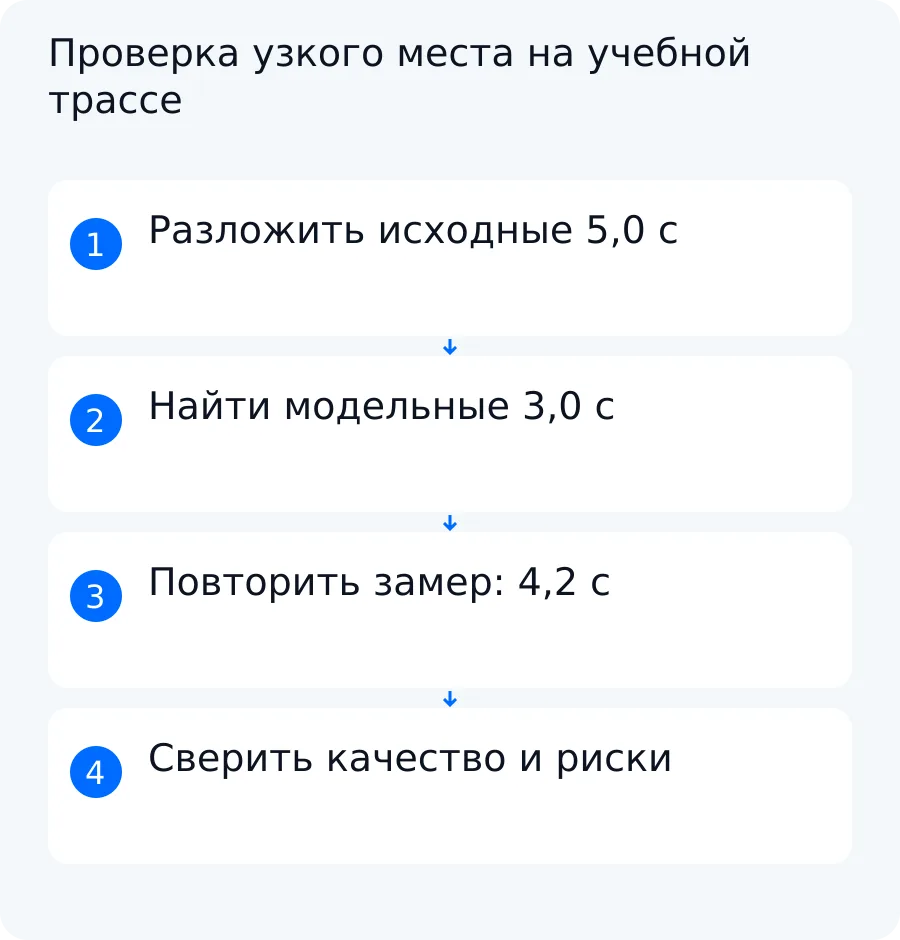
Исходное полное время складывается из неперекрывающихся участков:
- поиск — 0,4 с;
- внешний инструмент — 1,1 с;
- модель — 3,0 с;
- прочее, включая условный участок очереди и сети, — 0,5 с;
- итого — 0,4 + 1,1 + 3,0 + 0,5 = 5,0 с.
Доля модели в учебной трассе равна 3,0 / 5,0 × 100% = 60%. Инструмент занимает 22%, прочее — 10%, поиск — 8%. Поэтому первым кандидатом на проверку становится модельный участок. Это вывод из синтетических исходных данных, а не обещание ускорения реального помощника.
Промежуточное решение: сохранить поиск и инструмент без изменений, а из модельного ввода убрать контекст, который не используется в ответе. Для повторного учебного расчёта примем длительность модели равной 2,2 с. Значение 2,2 с — допущение демонстрации, а не проведённый замер.
| Этап | Время до | Изменение | Время после | Качество | Риск |
|---|---|---|---|---|---|
| Поиск | 0,4 с | без изменения | 0,4 с | проверить актуальность и состав найденных фрагментов | устаревшие результаты |
| Инструмент | 1,1 с | без изменения | 1,1 с | проверить статус и корректность результата | тайм-аут или неверный результат |
| Модель | 3,0 с | сокращён ненужный контекст | 2,2 с | сравнить полноту, фактические ошибки и формат | потеря нужного контекста |
| Прочее: очередь и сеть | 0,5 с | без изменения | 0,5 с | проверить, что интервалы учтены один раз | изменчивая нагрузка |
| Итого | 5,0 с | повторный условный расчёт | 4,2 с | принять только после проверки ответов | перенос узкого места |
Если таблица не помещается, прокрутите её вправо. С клавиатуры используйте стрелки.
Таблица задаёт критерии будущей проверки, но не изображает проведённый тест. В рабочей системе вывод о качестве нужно подтвердить на контрольной выборке.
Повторный условный итог: 0,4 + 1,1 + 2,2 + 0,5 = 4,2 с. Разница составляет 5,0 − 4,2 = 0,8 с. Относительное сокращение полного времени в примере равно 0,8 / 5,0 × 100% = 16%. Эти 16% нельзя переносить на другую модель, другой контекст или реальную систему без замера.
После изменения узкое место могло переместиться. Теперь модель занимает 2,2 / 4,2 ≈ 52% полного времени, а инструмент по-прежнему требует 1,1 с. Следующая итерация начинается с новой трассы, а не с автоматического продолжения оптимизации модели.
Как проверить результат перед запуском
Перед запуском проверьте определения и происхождение каждого числа. TTFT должен вычисляться по первому токену, а полное время — по последнему. Учебные числа должны оставаться помеченными как синтетические. Условное сокращение на 16% нельзя называть замером Switch On AI.
Нормальный путь
Вход: все временные отметки присутствуют; интервалы не перекрываются либо перекрытия явно учтены.
Ожидаемый результат: система рассчитывает TTFT и полное время, а сумма четырёх неперекрывающихся этапов учебной трассы равна 5,0 с.
Сигнал ошибки: сумма этапов расходится с полной длительностью или TTFT оказался больше времени до последнего токена.
Действие человека: разработчик проверяет единицы измерения, границы интервалов, синхронизацию часов и параллельные участки. До исправления такую трассу не используют в сравнении.
Исключение: инструмент завершился тайм-аутом
Вход: внешний инструмент не вернул корректный результат в разрешённое время.
Ожидаемый результат: trace получает статус ошибки и не смешивается с успешной выборкой. Пользователь видит согласованное сообщение или запрос передаётся человеку — в зависимости от правил процесса.
Сигнал ошибки: отсутствует корректное время завершения, результат инструмента пуст или приложение сообщает об успехе после тайм-аута.
Действие человека: владелец интеграции проверяет лимит времени, правила повтора и журнал вызова. Затем команда отдельно повторяет сценарий ошибки и обычный сценарий.
Финальная выборка должна содержать исходные и повторные запросы с одинаковыми идентификаторами сценариев. Если изменились модель, нагрузка, документы или правила инструмента, отметьте это как новое условие сравнения.
Что согласовать для внедрения
Готовая функция провайдера может дать streaming, сведения о токенах или встроенную телеметрию, но она не знает границ вашего процесса. Собственная интеграция связывает приём запроса, retrieval, модель и инструменты одним trace_id, сохраняет нужные отметки и задаёт обработку исключений. Конкретные возможности API, тариф, права и совместимость проверяются отдельно для выбранной платформы.
Switch On AI может разработать ИИ-помощника, бота или интеграцию для этой операции после проверки данных и доступного API. Задача проекта формулируется конкретно: разделить задержки поиска, модели и внешних инструментов, выбрать одну гипотезу и проверить её на согласованном наборе запросов. Это не обещание заранее известного эффекта или срока.
ИИ-помощник уместен, если модель ищет сведения, выбирает разрешённый инструмент или готовит ответ. Чат-бот описывает диалоговый канал. Обычная интеграция подходит, если шаги заранее определены и модели не нужно выбирать действие. Подробнее о составе такой разработки — на странице ИИ-агентов для бизнеса.
Для первой оценки подготовьте обезличенную трассу одного медленного запроса: временные отметки, число токенов, статусы retrieval и инструментов, ожидаемый результат и фактический ответ. Не передавайте пароли, ключи и клиентские данные. На разборе можно выбрать одну операцию и согласовать границы прототипа. Прототип проверяет ключевой сценарий, но не равен полному внедрению.
Работа с 1С в этот объём не входит. Switch On AI не предлагает в рамках этого сценария внедрение PIM, WMS, ITAM, ЭДО, электронного архива, Process Mining, полноценного B2B-портала, управления запасами, маршрутизатора или корпоративного обучения. Если операция затрагивает профессиональные правила учёта, их задаёт и принимает специалист заказчика.
Следующий шаг — обсудить одну операцию, разобрать обезличенную трассу медленного запроса и согласовать прототип без гарантии заранее заданного ускорения.
Вопросы по этой задаче
Почему streaming кажется быстрее?
Пользователь раньше видит первый фрагмент ответа, поэтому система воспринимается отзывчивее. При этом streaming не обязан сокращать время до последнего токена: TTFT и полное время нужно измерять отдельно.
Всегда ли маленькая модель быстрее?
Нет. Размер модели — только один из факторов. Результат зависит от платформы, нагрузки, объёма ввода и вывода и самого сценария. Модели сравнивают на одинаковых запросах по TTFT, полному времени, качеству, ошибкам и стоимости.
Как найти медленный инструмент?
Запишите начало, завершение и статус каждого вызова под общим trace_id. Сравните медиану и p95 для одинаковых сценариев, а тайм-ауты анализируйте отдельно от успешных запросов. Очередь и сетевой обмен не следует автоматически включать во время инструмента или модели.